
들어가기 앞서서
프로그래밍을 하다 보면 늘 드는 생각이 있다. 재밌고 좋은 문제는 다 선배 프로그래머가 풀어놓았고, 나는 그 위에 남은 것을 얹는다는 생각이다. 우리가 흔히 패턴이라고 말하거나 방식이라고 하는 것들은 다 산업현장에서 선배 프로그래머들의 피로 만들어진 것이다.
그런데 그 선배들이 풀어놓은 문제와 그들이 만든 소프트웨어를 들여다보면, 상당수는 지금 사라졌다.
수많은 프로그램이 만들어졌지만 대부분은 더 이상 실행되지 않는다. 어떤 프로그램은 완전히 새로 쓰인 것으로 대체됐고, 어떤 프로그램은 그것을 실행할 환경이 사라졌고, 어떤 프로그램은 소스코드만 남아 오픈소스 책에 박제되어 있다.
소프트웨어는 특이한 생산물이다. 다 만들어진 뒤에도 쓰이는 동안 계속 고쳐지고, 시간이 흐를수록 처음 만들어졌을 때의 모습을 잃어간다.
옛날 배의 널빤지를 하나씩 새것으로 바꾸다 보면, 모든 부품이 교체된 뒤에도 그 배를 같은 배라고 할 수 있을까.
테세우스의 배로 불리는 이 질문이 소프트웨어에도 그대로 적용된다. 코드를 한 줄씩 고치다 보면 처음의 코드는 하나도 남지 않는데, 우리는 여전히 그것을 같은 프로그램이라고 부른다.
그렇다면 대체 우리는 무엇을 만들고 있는 것일까. 처음 만든 것이 하나도 남지 않는데도 같은 프로그램이라고 부를 수 있다면, 우리가 만드는 것은 코드인가, 아니면 코드가 계속 고쳐질 수 있게 하는 무엇인가.
소프트웨어 산업과 위기
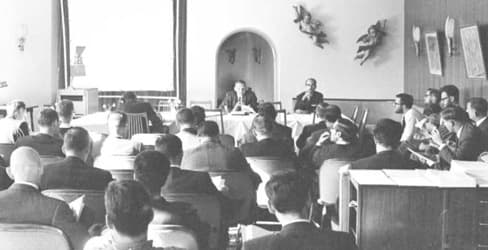
(1968년 10월, NATO 과학위원회 이미지 출처-Software Technology Group1)
우선 시작점을 찾아보자. 많은 사람들이 서로 다른 시작점을 잡지만, 나는 1968년의 Software Engineering conference 를 시작으로 잡겠다.
소프트웨어에는 언제나 '위기'라는 수식어가 따라 붙었다. 소프트웨어 엔지니어는 어쩌면 호들갑을 떠는 것이 직업인지도 모르겠다.
1968년 10월, NATO 과학위원회는 독일 가르미슈에서 소프트웨어 개발의 문제를 논의하는 회의를 열었다. 이 회의에 붙은 '소프트웨어 공학(Software Engineering)'이라는 이름은 이미 완성된 학문을 가리킨 것이 아니라, 소프트웨어 제작에도 다른 공학 분야처럼 이론적 토대와 실무적 규율이 필요하다는 요구였다.
위기는 왜 발생했는가? 하드웨어의 성능은 빠르게 오르는데 소프트웨어를 만드는 방법은 그 속도를 따라가지 못했다. 이전에는 불가능했던 일이 가능해지자 사람들은 더 크고 복잡한 시스템을 요구했고, 개발 일정은 지연되고, 예산은 초과되고, 프로그램이 커질수록 오류를 통제하는 일은 어려워졌다.
듣고 보면 익숙하지 않은가? 소프트웨어의 역사는 어찌 보면 개발 일정 지연, 예산 초과, 복잡성 통제의 문제와 함께 했다고 할 수 있다.
그런데 이 위기를 단순히 기술이 부족했던 시대의 문제로 국한할 것인가? 아니면 기술이 충분히 발전되면 문제가 없을까?
흥미로운 것은 당시 컴퓨터 과학자들이 이 문제를 서로 다르게 바라보았다는 점이다. 누군가는 인간이 감당할 수 있는 복잡성의 한계를 논했고, 프로그램을 어떻게 나누어야 하는지 고민했으며, 또 다른 누군가는 프로그램을 만드는 행위가 왜 필요로 하는지 물었다.
그렇다면 그들은 우리가 만드는 소프트웨어를 무엇이라고 생각했을까?
먼저 1972년 튜링상 강연에서 '겸손한 프로그래머'를 외친 에츠허르 다이크스트라부터 살펴보자.
1968년 회의가 던진 문제의식을 4년 뒤에 정면으로 다룬 사람이다
(에츠허르 다이크스트라)
1. 1972년 - 다이크스트라: 인간이 이해할 수 있는 범위 안에서 만들기
As a result of a long sequence of coincidences I entered the programming profession officially on the first spring morning of 1952 and as far as I have been able to trace, I was the first Dutchman to do so in my country. In retrospect the most amazing thing was the slowness with which, at least in my part of the world, the programming profession emerged, a slowness which is now hard to believe. But I am grateful for two vivid recollections from that period that establish that slowness beyond any doubt.
여러 우연이 길게 이어진 끝에, 나는 1952년 봄의 첫 아침에 정식으로 프로그래밍이라는 직업에 들어섰다. 내가 확인할 수 있는 바로는, 우리나라에서 그 일을 한 첫 네덜란드인이었다. 돌이켜보면 가장 놀라운 것은, 적어도 내가 있던 세상에서는 프로그래밍이라는 직업이 등장한 속도가 매우 느렸다는 점이었다. 지금은 믿기 어려울 정도의 느림이었다. 그러나 나는 그 시절의 생생한 기억 두 가지에 감사하는데, 그것들이 그 느림을 의심할 여지 없이 입증해 준다.
The Humble Programmer - 1972
에츠허르 다이크스트라(Edsger W. Dijkstra)의 「The Humble Programmer」는 1972년 튜링상 강연이며, 같은 해 10월 『Communications of the ACM』에 실렸다. 여기서 겸손은 프로그래머가 자기 사고 능력의 한계를 인정하는 태도를 가리킨다. 머리가 좋은 사람이면 복잡한 프로그램도 모두 기억할 수 있다는 기대를 버리고, 이해하고 추론할 수 있는 형태로 프로그램을 구성하는 방법을 찾자는 것이다.2
지금 읽어봐도 재밌게 쓰여진 원문인데, 그중에서 가장 재밌게 읽히는 부분은 다음과 같다.
The competent programmer is fully aware of the strictly limited size of his own skull; therefore he approaches the programming task in full humility, and among other things he avoids clever tricks like the plague.
유능한 프로그래머는 자기 두개골의 엄격히 제한된 크기를 충분히 의식한다. 따라서 그는 완전한 겸손함으로 프로그래밍 과제에 접근하며, 무엇보다도 교묘한 수법을 흑사병처럼 피한다.
프로그래머에게 영리한 기교를 피하라니, 언뜻 보면 이상한 말이다. 우리는 흔히 복잡한 문제를 짧고 간결한 코드로 해결하는 사람을 뛰어난 프로그래머라고 생각하기 때문이다.
그렇다면 다이크스트라가 지적한 것은 무엇인가? 지능의 부족이 아니라 인간의 사고 능력 자체에 존재하는 한계였다.
그렇다면 왜 다이크스트라는 이 두개골의 크기를 문제 삼았을까? 컴퓨터는 점점 빨라지고 더 많은 명령을 처리할 수 있게 되었지만, 그 프로그램을 이해해야 하는 인간의 두뇌가 같은 속도로 발전한 것은 아니다. 그렇다면 해결책은 인간의 능력을 무한히 확장하는 것이 아니라, 제한된 능력으로도 이해할 수 있는 프로그램을 만드는 데 있다.
짧은 코드 한 줄이 개념적으로 더 많은 것을 담고 있다면 그것은 압축이다. 그러나 읽는 사람이 풀어야 할 퍼즐을 만들어놓았다면 그것은 압축이 아니라 낭비다. 같은 계산을 더 적은 기호로 적었다는 사실만으로는 둘을 구별할 수 없다. "이걸 더 적은 기호로 짤 수 있나?"라는 질문에 개념적 관련이 없다고 그가 단언하는 이유가 여기에 있다. 그가 말하는 간결함은 기호의 수가 아니라, 읽는 사람이 논리의 흐름을 투명하게 따라갈 수 있게 만드는 개념적 명료함이다.
물론 코드 골프를 좋아하는 사람이 있겠지만, 어쨌건 다이크스트라는 말한 간결함과는 거리가 있을 것이다.
처음 이야기했던 테세우스의 배를 다시 머릿속에 그려보자. 프로그램은 시간이 흐르면서 계속 수정되고, 처음 작성한 코드는 사라질 수 있다. 그러나 새로운 코드를 작성한 사람이 그 프로그램의 동작을 이해하고 올바름을 설명할 수 있다면, 적어도 이전 프로그램이 해결하던 문제를 이어받을 가능성은 남아 있다. 하지만 만약 그것이 압축된 체계라서 해석하기가 매우 힘들다면?
그렇다면 유지보수가 불가능해지는 것이다. 아무리 이해하기 쉽게 만든 프로그램이라도 시간이 흐르면 수정해야 한다. 새로운 기능이 추가되고, 요구사항이 바뀌고, 기존의 설계는 환경에 맞지 않게 도태된다.
그렇다면 프로그램을 이해할 수 있도록 만드는 것에서 한 걸음 더 나아가, 프로그램이 바뀌더라도 그 이해를 가능한 한 유지할 방법은 없을까?
이 문제를 살펴보기 위해 1972년 데이비드 파르나스(David Parnas)가 발표한 논문으로 넘어가 보자.
(David L. Parnas)
2. 1972년 - 파르나스: 처리 순서보다 바뀔 결정을 중심에 놓다.
같은 해 12월, 데이비드 파르나스(David L. Parnas)는 「On the Criteria To Be Used in Decomposing Systems into Modules」를 발표했다. 이 논문은 프로그램을 모듈로 나누면 좋다는 말에서 멈추지 않고, 무엇을 기준으로 나누느냐에 따라 결과가 달라진다는 것을 보여준다.3
Every module in the second decomposition is characterized by its knowledge of a design decision which it hides from all others. Its interface or definition was chosen to reveal as little as possible about its inner workings.
두 번째 분해에서 모든 모듈은 다른 모든 모듈로부터 감추는 설계 결정에 대한 지식으로 특징지어진다. 그 인터페이스나 정의는 내부 작동에 관해 가능한 한 적게 드러내도록 선택된다.
그는 예제로 KWIC(Key Word in Context)라는 색인 시스템을 바탕으로 모듈로 나누는 두 가지 방식을 비교한다. 하나는 입력, 순환 이동, 정렬, 출력 같은 처리 단계마다 모듈을 두는 방식이고, 다른 하나는 저장 방식처럼 바뀔 수 있는 설계 결정을 한 모듈에 감추고 다른 모듈은 그 인터페이스로만 사용하게 하는 방식이다.
두 번째 방식에서 모듈의 경계는 실행 단계와 꼭 일치하지 않는다. 파르나스는 두 번째 분해에서 각 모듈을 "다른 모듈로부터 감추는 설계 결정"으로 특징지었고, 이 기준이 뒤에 정보 은닉(information hiding)이라는 이름으로 널리 쓰이게 된다.
여기서 감추는 대상은 다른 모듈이 알 필요가 없는 내부 결정이다. 저장 표현을 바꿨는데 그 표현과 이어졌던 코드가 사방에서 깨진다면, 파일을 여러 개로 나눠놓았더라도 변경의 관점에서는 여전히 한 덩어리에 가깝다고 할 수 있을 것이다.
KWIC의 두 번째 분해가 보여준 이점은 저장 표현을 감춘 모듈 안으로 그 수정의 범위를 줄일 수 있다는 데 있다고 할 수 있다.
이것이 앞 절에서 남긴 질문에 대한 파르나스의 대답이라고 할 수 있다. 프로그램이 바뀌어도 이해를 유지하려면, 각 부분을 이해하는 데 다른 부분의 내부를 알 필요가 없도록 경계를 그어야 한다. 구조를 살필 때 무엇이 바뀔 가능성이 있고 어느 모듈이 그 결정을 감추고 있는지, 바꿀 때 어디까지 영향을 받아도 되는지를 함께 보게 된다.
파르나스의 정보 은닉은 바로 이러한 불확실성에 대응하는 방법이다. 설계 결정이 바뀌더라도 그 영향이 프로그램 전체로 퍼지지 않도록 하는 것이다.
하지만 상식적으로 생각해보자. 우리는 전지전능하지 않다. 당장 1분 후의 일도 알지 못한다. 나만 해도 클라이언트가 내일부터 계약을 끊겠다고 통보하기 30초 전까지 그런 일이 생길 줄 몰랐다.
파르나스는 어렵거나 변경될 가능성이 높은 설계 결정을 모듈 안에 감추라고 제안했다. 그런데 무엇이 바뀔 가능성이 높은지는 누가 판단하는가?
어떤 개발자는 데이터베이스를 교체할 가능성이 높다고 생각하고, 다른 개발자는 비즈니스 규칙이 자주 변경될 것이라고 생각할 수 있다. 그리고 직급이 높은 쪽이 이기겠지만 어쨌건, 두 사람 모두 정보 은닉이라는 같은 원칙을 따르더라도 서로 다른 모듈 경계를 그릴 수 있다.
결국 무엇을 감추고 어디에 경계를 그을 것인가는 설계자의 경험과 지식, 그리고 미래에 대한 예상, 즉 프로그래머의 세계관 영향을 받는다.
우리가 좋은 설계라고 부르는 것에는 아직 일어나지 않은 미래에 대한 가설이 포함되어 있는 셈이다.
다시 테세우스의 배의 예시로 돌아가자. 우리는 불확실성 속에서 배의 판자를 고쳐야 할 때, 배의 척추라고 할 수 있는 용골을 피하는 방식을 찾는다.(용골이 뭔지 모르는 분들을 위해: 원피스를 보면 된다. 워터 세븐 편을 보면서 눈물 흘리지 않는 사람은 감정이 메마른 사람이다.) 파르나스의 정보 은닉은 바로 그 방법에 가깝다. 판자를 바꾸는 일이 용골까지 흔들지 않도록, 판자와 용골 사이에 경계를 긋는 것이다.
그렇지만 여기서 질문을 조금 더 깊게 생각해보자. 우리는 지금까지 프로그램을 어떻게 이해하고, 변경에 대비할 것인지 고민했다.
그렇다면 도대체 왜 소프트웨어는 계속 바뀌어야하는 것일까?
왜 테세우스의 배는 계속 수리되어야하는가?
이 질문을 실제 소프트웨어의 변화 과정에서 살펴본 사람들이 있었다. 메이어 레먼(Meir M. Lehman)과 라슬로 벨라디(László Belady)다.
(메이어 레먼)
(라슬로 벨라디)
3. 1976년 - 레먼과 벨라디: 프로그램은 어떻게 변해가는가?
라슬로 벨라디(László A. Belady)는 원래 운영체제 쪽 사람이었다. 1966년 IBM에서 가상 메모리의 페이지 교체를 연구하면서, 메모리가 꽉 찼을 때 '앞으로 가장 오랫동안 쓰이지 않을 페이지'를 내보내는 것이 최적이라는 기준을 제시했다. 지금도 운영체제 교과서에 OPT, MIN, 또는 벨라디 알고리즘이라는 이름으로 나온다.
재밌는 점은 이 알고리즘이 현실에서는 구현할 수 없는 알고리즘이라는 사실이다. 앞으로 어떤 페이지가 언제 쓰일지 미래를 미리 다 알아야만 동작하기 때문이다. 결국 이론적인 최적 기준점을 잡기 위해 미래를 가정한 사람인데, 그런 그가 메이어 레먼(Meir M. Lehman)과 손을 잡고 연구한 주제가 바로 '시간이 흐르면서 실제로 소프트웨어가 어떻게 변해가는가'였다는 사실은 묘한 여운을 남긴다.
두 사람은 IBM의 거대 운영체제인 OS/360이 릴리스를 거듭하며 어떻게 비대해지고 바뀌어 갔는지를 수년간 추적해 1976년 「A Model of Large Program Development」를 발표했다. 그리고 레먼은 이 연구를 더욱 확장해 1980년 「Programs, Life Cycles, and Laws of Software Evolution」에서 소프트웨어 진화의 원리를 정리한다.45
앞에서 우리는 파르나스를 통해 "바뀔 만한 부분을 모듈 뒤로 숨기자" 라는 결론을 내렸다. 그런데 레먼과 벨라디는 한 걸음 물러서서 더 근본적인 질문을 던진다. 이것이야말로 발상의 전환이다.
그렇지만 도대체 소프트웨어는 왜 가만히 있지 못하고 계속 바뀌어야만 하는가? 기계와 달리 마찰때문에 부품이 닳아서 수리가 필요한게 아닌데도 말이다.
레먼은 1980년 논문에서 우리가 흔히 겪는 이 끝없는 수정의 굴레를 다음과 같이 설명한다.
"The installation of the program together with its associated system... change the very nature of the problem to be solved. The program has become a part of the world it models, it is embedded in it."
"Differences between data derived from observation and from computation may cause changes in the world view... It is the perception of users, analysts and/or programmers that has changed."
프로그램의 설치와 시스템은 해결해야 할 문제의 본질 자체를 바꾼다. 프로그램은 자신이 모델링하는 세상의 일부가 되어버린다. 관찰과 계산에서 나온 데이터의 차이는 세계관의 변화를 일으키며, 결국 사용자와 프로그래머의 '인식' 자체가 변해버린 것이다
Programs, Life Cycles, and Laws of Software Evolution - 1980
이 문장을 보면 현대 프로그래밍의 문제점이 고스란히 드러난다. 이미 50여년전에 프로그래머 선배들이 다 정리한 이야기를 아직도 하고 있는 것이다. 늘 재밌고 좋은 것은 선배들이 하고, 쭉정이는 후배들이 한다. 이게 프로그래밍이다.
어쨌건, 레먼은 프로그램을 세 가지(S형, P형, E형)로 나눴다. 입력과 출력의 수학적 명세만 맞으면 끝나는 프로그램(S형)이나, 체스 프로그램처럼 정해진 규칙은 있지만 현실적 제약때문에 근사해를 찾는 프로그램(P형)은 세상이 바뀐다고 같이 흔들릴 일이 별로 없다. 진짜 골치 아픈 것은 현실 세계의 업무와 사람들의 일상에 직접 끼어들어 돌아가는 프로그램, 즉 E형(Embedded) 프로그램이다.5
왜 E형 프로그램은 끊임없이 수리를 필요로 하는가? 우리가 처음 요구사항을 잘못 이해했기 때문에? 잘못된 정답을 도출했기 때문에?
정확히는 프로그램이 세상에 들어가는 순간, 그 프로그램으로 인해 세상이 바뀌기 때문이다.
중소 쇼핑몰에 상품 검색과 추천 알고리즘을 납품한다고 가정하자. 처음엔 분명히 소비자들이 원하는 물건을 쉽게 찾게 될 것이고, 판매자들은 매출이 오르자 아주 만족할 것이다.
그런데 추천 알고리즘이 돌아가면서, 쇼핑몰에 물건을 올리는 판매자들은 조회수를 올리기 위해 상품명에 온갖 관련 없는 키워드를 도배하기 시작한다(키워드 스터핑). 심지어 판매자 중에 영리한 사람은 프로그램까지 쓴다!(물론 그 프로그램도 보통은 나를 통한다. 나는 쇼핑몰 추천 알고리즘도 만들지만, 그 쇼핑몰 추천 알고리즘을 악용할 수 있는 프로그램도 판다. 양쪽 다에게 프로그램을 납품하는 것이다.)
그럼 기존 알고리즘은 이 키워드가 잔뜩 박힌 상품을 여전히 관련성 높은 상품으로 훑을 것이다. 그러면 클라이언트가 당신에게 전화를 걸어 말할 것이다.
"아니, 추천 정확도가 떨어졌고, 이상한 상품만 올라오는데, 어떻게 된건가요?"
프로그램이 고장 난 걸까? 아니다. 프로그램이 너무 좋아서 판매자들의 이득 추구 행동을 자극했고, 소비자들의 탐색 습관을 망가뜨렸고, 그에 따라 시장의 질서가 바뀌게 된 것이다. 그러면 바뀐 시장에 기존 알고리즘이 맞지 않게 되는 것이다.
다시 테세우스의 배를 떠올려 보자. 배의 목적은 무엇인가? 항해를 하는 것이다. 보통은 근해안에서 항해를 하지만, 어떤 성능이 너무 좋은 배는 사람들이 그 배를 타고 예전에는 가지 않던 거친 먼바다로 나가기 시작했고, 더 무거운 화물을 싣기 시작했기 때문에 판자를 계속 새로 덧대야 하는 것이다. 배가 항해의 범위를 넓혔고, 넓어진 항해가 배를 다시 고치게 만든다.
레먼이 정리한 '소프트웨어 진화 법칙' 그래서 대단한 것이다.
"실제 사용되는 프로그램은 계속 바뀌어야 하며, 그렇지 않으면 점점 쓸모없어진다(지속적 변화)."
"복잡도를 줄이려는 별도의 작업을 하지 않는 한, 프로그램이 진화할수록 구조는 점점 더 복잡해진다(복잡도 증가)."
인간의 두개골에 넣을 수 있을만큼 간단하게 프로그래밍을 만들자, 누군가는 모듈이라는 것에 정의 내려서 그 안에 결정을 숨기자고 했다. 하지만 레먼과 벨라디의 관찰은 아무리 잘 짜고 잘 숨겨놓아도 프로그램이 현실에서 살아 숨 쉬는 이상 변경의 파도는 멈추지 않고 밀려오며 기어이 복잡도는 치솟는다는 것이다.
그렇다면 이쯤에서 아주 근본적인 의심이 하나 고개를 든다. 우리가 프로그램을 만들고 고치는 일이 이토록 고달픈 이유가, 혹시 우리가 처음부터 생각하는 방식과 사용하는 언어의 틀을 잘못 끼웠기 때문은 아닐까?
기계가 일하는 순서대로 명령어를 한 줄씩 나열하고 고치는 방식 자체에 시비를 건 사람이 있었다. 1977년 튜링상 연단에 선 존 배커스(John Backus)다.
(존 배커스)
4. 1978년 - 배커스: 명령의 흐름 대신 계산의 조합으로 보기
프로그래머는 기본적으로 세상에 불만이 많은 족속들이다. 프로그래머의 역사는 어쩌면 싸움의 역사이고, 어쩌면 관념과의 전쟁이다. 한명 한명이 전부 자기만의 세계관에 사로잡혀서 컴퓨터라는 기계를 돌릴려고 한다.
그중에서도 존 배커스는 특이하다. 기계의 방식에 맞춰 코딩하는 것에 지친 나머지, 아예 기계를 동작하는 방식 자체를 바꿔버리려 들기 때문이다.
존 배커스(John Backus)의 「Can Programming Be Liberated from the von Neumann Style? A Functional Style and Its Algebra of Programs」는 1977년 튜링상 강연을 바탕으로 1978년 8월에 게재됐다. FORTRAN 개발을 이끈 사람이 익숙한 명령형 프로그래밍의 표현 방식을 다시 문제 삼은 글이다.6
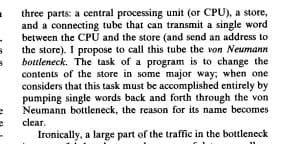
a store, and a connecting tube that can transmit a single word between the CPU and the store (and send an address to the store). I propose to call this tube the yon Neumann bottleneck. The task of a program is to change the contents of the store in some major way; when one considers that this task must be accomplished entirely by pumping single words back and forth through the von Neumann bottleneck, the reason for its name becomes clear.
중앙처리장치(CPU), 기억장치(store), 그리고 CPU와 기억장치 사이에서 한 번에 한 워드씩 전송하며 기억장치에 주소를 보낼 수 있는 연결관. 나는 이 관을 폰 노이만 병목(von Neumann bottleneck)이라고 부르고자 한다. 프로그램의 과제는 기억장치의 내용을 어떤 큰 방식으로 바꾸는 것이다. 이 과제가 전적으로 폰 노이만 병목을 통해 워드를 하나씩 주고받는 방식으로만 수행되어야 한다는 점을 생각해 보면, 그 이름이 붙은 이유가 분명해진다.
그가 비판한 것은 무엇인가? 기억장치의 값을 읽고, 쓰는 기계의 동작 방식이 프로그램을 생각하는 프로그래머의 사고 방식까지 지배한다는 점이었다. 그는 CPU와 기억장치 사이에서 한 번에 한 워드씩 오가는 통로를 '폰 노이만 병목(von Neumann bottleneck)'이라고 불렀고, 변수에 하나씩 대입하는 명령형 언어가 같은 병목을 사고 습관 안으로 들여왔다고 보았다.6
대안으로 제시한 FP 체계의 핵심은 '어떻게(How)'를 명령하는 대신 '무엇(What)'을 조합하는 것이다. 함수들을 정해진 결합 형식으로 이어 붙이고, 그 조합의 성질을 수학의 대수(algebra)처럼 다룬다.
결합 형식에는 합성(composition), 구성(construction), 조건(condition), 모든 원소에 적용(apply-to-all), 삽입(insert, 오늘의 fold에 가까움) 등이 있다. 변수에 무엇을 차례로 대입했는지 따라가는 대신, 계산들을 어떻게 연결했고 어떤 변환이 의미를 유지하는지 설명하려는 방향이다.
다이크스트라가 인간의 두개골이 얼마나 작은지 인정하고, 그 안에서 프로그램을 이해할 수 있어야 한다고 말했다면, 배커스는 여기서 한 걸음 더 나아갔다. "왜 애초에 인간이 기계의 상태 변화를 일일이 따라가며 프로그램을 설명해야 하는가?" 다이스트라가 '겸손한 프로그래머'를 외쳤다면, 존 배커스는 기계(와 언어)를 향해 인간에게 겸손하라고 요구한 셈이다.
물론 그의 FP 체계가 오늘날의 표준 프로그래밍 방식이 된 것은 아니다. 하지만 그의 사고방식은 오늘날 인기 있는 언어 곳곳에 깊숙이 박혀 있다. 현대 언어들이 자랑하는 map, filter, reduce 같은 함수형 도구들은 이제 선택이 아닌 기본에 가깝다. 시니어 프로그래머 면접의 단골 손님들이 이렇게 탄생한 것이다.
다시 테세우스의 배로 돌아가자. (안다. 이 비유가 지겹다는 거 하지만 어쩌겠는가 나는 이 비유를 끝까지 쓰기로 마음 먹었는 걸.)
레먼과 벨라디가 "환경이 변하니 배의 판자를 계속 갈아 끼워야 한다"는 숙명을 이야기했다면, 배커스는 그 판자를 갈아 끼우는 '망치와 톱(언어)의 구조' 자체에 문제를 제기한 사람이었다.
테세우스의 배를 다시 고쳐야 한다면, 이제 우리는 아주 현실적인 질문에 직면한다. "이 판자를 갈아 끼우는 데 드는 비용은 얼마인가? 그리고 이 배가 항해 도중 침몰할 위험은 얼마나 되는가?"
레먼이 소프트웨어가 진화할 수밖에 없다는 숙명을 밝혀냈지만, 그 진화의 과정은 엄청난 비용과 리스크를 동반했다. 1970년대 후반, 미 국방부(DoD)의 거대 소프트웨어 프로젝트들이 연이어 실패로 끝나자, 소프트웨어 공학의 무게중심은 '어떻게 잘 짤 것인가'에서 '어떻게 예측하고 통제할 것인가'로 이동한다.
이 문제에 정면으로 뛰어든 사람이 바로 배리 보엠(Barry Boehm)이다.
(배리 보엠)
5. 1981년 - 보엠: 기술 선택을 경제적 판단과 함께 보기
개인적으로 나는 배리 보엠을 프리랜서 프로그래머의 수호성인이라고 생각하는 편이다. 아무리 멋진 설라도 돈이 없으면 만들 수 없다. 아무리 좋은 언어를 사용하더라도 납기를 맞추지 못하면 클라이언트는 화를 낸다.
프로그래머에게 이론적 올바름이 중요하지만, 돈을 지불하는 사람을 위한 비용과 일정도 맞춰야한다.
배리 보엠(Barry W. Boehm)이 1981년에 출간한 『Software Engineering Economics』에는 소프트웨어 개발의 노력·비용·일정을 추정하는 COCOMO(COnstructive COst MOdel)가 소개돼 있다. 7
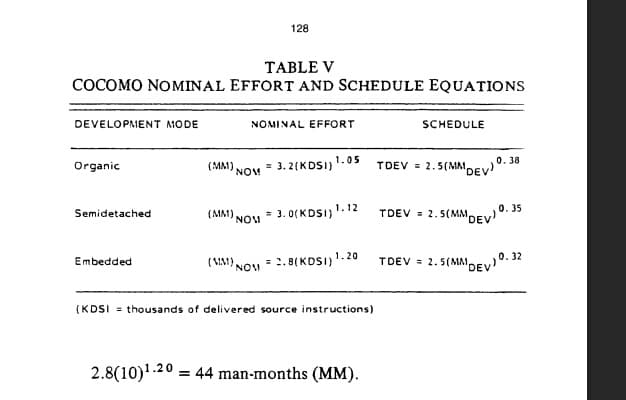
(그림. COCOMO의 프로젝트 유형별 명목 개발 노력 및 일정 추정식. 출처: Barry W. Boehm, 원문 p.128, Table V.)
그는 여러가지 방식으로 소프트웨어의 일정을 추정했지만, 개인적으로 가장 흥미있게 본 부분은 소프트웨어를 3 가지 유형으로 나눈 뒤, 각각 다른 공식으로 개발에 필요한 노력을 추정하였다.
Organic은 상대적으로 익숙하고 제약이 적은 개발 환경, Semidetached는 그 중간, Embedded는 하드웨어나 운영 환경의 엄격한 제약을 따라야 하는 개발 유형이다. (참고로 앞서 레먼이 설명한 E형(Embedded) 프로그램과는 전혀 다른 분류이니 혼동하지 말자.)
여기서 COCOMO 81은 기본 3개의 모형으로 되어 있는데, 3가지 분류는 다음과 같다.
단순(Basic) 모형은 규모(KDSI)와 프로젝트 유형만으로 노력을 추정한다.
중간(Intermediate) 모형은 여기에 제품·하드웨어·인력·프로젝트 특성 15가지를 반영한 조정 계수(EAF)를 곱한다.
상세(Detailed) 모형은 같은 EAF를 프로젝트 전체에 한 번 적용하는 대신, 설계·구현·통합 같은 개발 단계별로 따로 적용한다. 단순에서 상세로 갈수록 더 많은 정보를 요구하고 추정이 정교해진다.
모든 계산 공식을 외우는 것은 의미가 없고, 프리랜서 프로그래머는 견적 산출이 가장 중요하므로, 여기선 중간 개발 모형을 예시로 계산을 해보겠다.
KDSI는 납품되는 소스 명령문 수를 천 개 단위로 나타낸 것이고, E는 사람-월(Man-Month) 단위의 개발 노력이다. 계수 a와 b는 프로젝트 유형에 따라 달라진다.
예를 들어 Embedded 유형으로 소스 명령문 약 1만 개를 작성한다고 가정해 보자.
즉 약 44인월(man-month)의 개발 노력이 필요하다는 추정이다. 물론 44인월은 개발 기간이 44개월이라는 뜻은 아니다. 총 작업량을 한 사람이 한 달간 일하는 양으로 환산한 것이다.
이 단위를 둘러싼 유명한 오해가 하나 있는데, 44인월이 필요하다고 44명을 투입하면 한 달 만에 끝난다는 생각이다.
1975년 프레더릭 브룩스는 『The Mythical Man-Month』에서 이 환산을 정면으로 비판했다. 그에 따르면 사람을 더 넣으면 프로젝트는 빨라지기는커녕 더 느려진다. 새로 온 사람을 교육하는 비용이 들고, 사람이 늘면 의사소통 경로가 사람 수의 제곱에 가깝게 늘어나기 때문이다. 브룩스는 이 책에서 "지연된 소프트웨어 프로젝트에 인력을 추가하면 더 늦어진다"고 썼고, 이 문장은 뒤에 '브룩스의 법칙'으로 널리 인용된다. 프로그래머는 부품처럼 끼워 넣는다고 성능이 선형적으로 증가하는 물건이 아니다. 물론 클라이언트는 대개 그렇게 생각하지만.
그런데 여기서 한 가지 문제가 생긴다. 아직 만들지도 않은 프로그램의 비용을 도대체 어떻게 정확하게 계산할 수 있을까?
보엠 역시 이 문제를 알고 있었다.
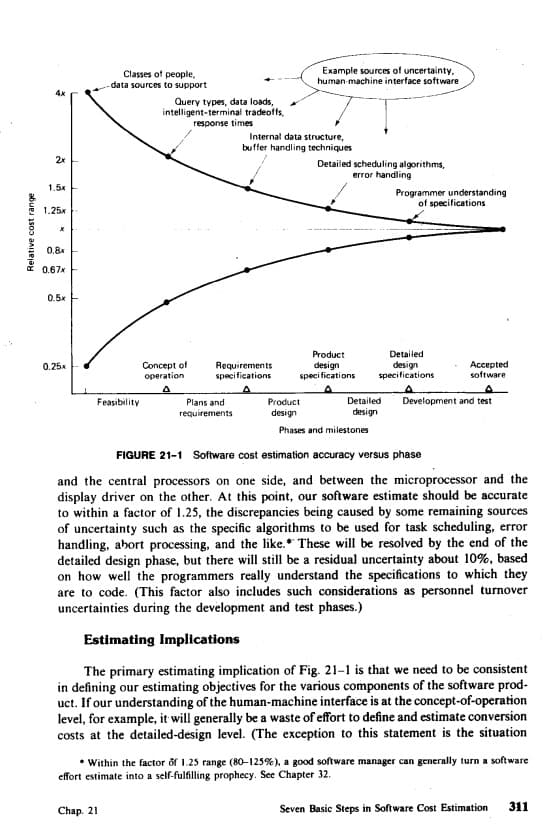
(그림. 개발 단계에 따른 소프트웨어 비용 추정의 정확도. Barry W. Boehm, Software Engineering Economics, 1981, p.311, Figure 21-1.)
1981년 『Software Engineering Economics』 311쪽에는 개발 단계에 따른 비용 추정의 불확실성을 보여주는 그림이 등장하는데, 그림을 보면 개발 초기에는 실제 비용이 추정치의 4분의 1에서 4배까지 차이 날 수 있는 범위를 제시하고 있다. 요구사항을 명확히 하고 설계를 구체화하고, 기술적인 문제를 해결함에 따라 범위를 조금씩 줄어든다.
이 그림은 훗날 '불확실성의 원뿔(Cone of Uncertainty)'이라는 이름으로 널리 알려지게 된다.
하지만 여기에는 단순한 함정이 하나 있다.
실제로 조사하고, 시험하고, 잘못된 가정을 발견해야만이 불확실성을 줄일 수 있다.무엇을 모르는지조차 모른 채로 개발을 계속하다 보면, 어느 순간 그 대가를 치르는 것이다.
이런 문제의식은 보엠이 1988년 발표한 「A Spiral Model of Software Development and Enhancement」에서도 이어진다.
흔히 나선형 모델이라고 부르는데, 복잡한 그림과 개발 단계를 모두 외울 필요는 없다. 여기서 기억해야 할 핵심은 하나다.
무엇이 가장 위험한지를 판단하고, 그 위험을 줄이기 위해 다음에 무엇을 할 것인지 결정한다는 것이다.
개발을 진행하기 위해 위험을 무시하는 것이 아니라, 위험을 확인하고 줄이는 일 자체를 개발의 일부로 삼는 것이다.
예시를 하나 잡자. 결제 시스템이다. 결제 버튼을 누른 뒤 사용자가 기다리는 시간은 짧아야 한다. 3초만 지나도 사용자는 두 번 누르고, 두 번 누르면 중복 결제가 된다. 소비자는 물고기와 같다. 생각을 할 시간을 주 탈출하려고 한다. 결제가 느리다는 것은 물고기가 생각할 틈을 준다는 것이다. 절대 고객에게 가성비를 생각하게 해선 안된다.
반면 결제가 승인된 뒤의 이미 잡은 물고기다. 정산, 알림, 회계 반영은 몇 초, 몇 분이 걸려도 당장 문제가 되지 않는다. 그래서 결제 승인은 동기로, 나머지는 비동기로 나누는 설계가 흔히 쓰인다. 한국에서 결제 시스템을 만들 때 흔히 배우는 원칙이다.
그러니까 사용자가 기다려야 하는 작업과 그렇지 않은 작업을 구분하는 것이다.
다시 테세우스의 배로 돌아가보자.선주는 다음 항해까지 2주밖에 시간이 없다고 말하고, 수리비로 1000달러를 주었다.
그런데 갑판은 삐걱거리고, 돛은 찢어져 있으며, 용골에도 균열이 생긴 것 같다.
무엇부터 고쳐야 할까?
돛은 눈에 보이니 쉽게 수리할 수 있다. 갑판도 판자를 교체하면 된다. 하지만 용골의 균열은 아직 확인되지 않았다. 배를 뜯어봐야 알 수 있고, 정말 균열이 있다면 배가 침몰할 수도 있다.
여기서 조선공이 가장 먼저 돛부터 수리한다면 어떨까? 수리는 순조롭게 진행되고, 작업 진척률도 올라갈 것이다.
그런데 출항한 다음 날 용골이 부러진다면?
보엠이 제시한 위험 중심 개발의 관점에서는, 당장 가장 손쉽게 고칠 수 있는 부분보다 실패했을 때 가장 큰 손실을 일으킬 수 있는 불확실성을 먼저 조사해야 한다.
테세우스의 배에도 예산과 납기가 있고, 모든 위험을 없앨 만큼의 돈과 시간이 주어지는 것은 아니다.
그렇다면 도대체 누가 무엇을 즉시 처리하고, 무엇을 나중에 처리해도 되는지 결정했는가?
프로그램을 하다보면 어떤 부분은 빠르게, 어떤 부분을 느리게 두고 고치지 말아야하는 부분이 있다.
내가 작업했던 어떤 곳의 API에는 절대 삭제하면 안되는 코드가 있었다. 그 코드를 삭제하니까 속도가 빨라졌다. 하지만 그 API를 삭제해서 나는 클라이언트에게 불려가서 혼난 적이 있다. 왜일까? 그 API는 서버의 부하를 줄이기 위해서 일부러 속도를 늦춘 것이었다.
문제는 그 사실이 메뉴얼에만 적혀 있었고, 코드상의 주석에는 적혀 있지 않았다. 물론 메뉴얼은 나에게 전달되지 않았다. 왜냐하면 클라이언트가 그 API 버전을 착각해서 이전 버전을 줬기때문이다.
어쨌건 우리는 흔히 코드는 남아 있지만, 코드를 만든 이유는 남아있지 않은 경우를 자주 본다.
파일은 보존됐고 실행도 잘 됐다. 그런데 그 코드를 안전하게 다루는 데 필요한 지식은 사라진 상태였다. 나는 코드를 읽을 수 있었지만, 그 코드를 이해하지는 못했던 것이다.
1985년, 피터 나우르는 이 차이에 이름을 붙였다. 그는 프로그램을 이론(theory)으로 보자고 제안한다.
(페테르 나우르)
6. 1985년 - 나우르: 프로그램을 바꿀 수 있는 이해도 남아 있는가
나우르는 아마 해커뉴스 등지에서 프로그래밍을 사랑하는 직장인들에게 가장 사랑받는 과학자일 것이다. 나우르는 프로그래머 단체 해고때마다 불려나온다. 특히 AI 시대에 가장 많이 불려오는 과학자일 것이다.
피터 나우르(Peter Naur)의 「Programming as Theory Building」은 1985년에 실렸다. 그가 말하는 이론은 수학적 명제나 형식 명세에 한정되지 않으며, 프로그램이 현실의 문제를 어떻게 다루고 왜 이런 형태를 취하는지 설명하면서 새로운 변경 요구에도 대응할 수 있는 이해를 가리킨다.8
The death of a program happens when the programmer team possessing its theory is dissolved. A dead program may continue to be used for execution in a computer and to produce useful results. The actual state of death becomes visible when demands for modifications of the program cannot be intelligently answered. Revival of a program is the rebuilding of its theory by a new programmer team.
프로그램의 죽음은 그 이론을 보유한 프로그래머 팀이 해체될 때 찾아온다. 죽은 프로그램이라도 컴퓨터에서 계속 실행되어 유용한 결과를 낼 수 있다. 실제 죽음의 상태는 프로그램 수정 요구에 대해 지적으로 답할 수 없을 때 표면으로 드러난다. 프로그램의 부활은 새로운 프로그래머 팀에 의해 그 이론이 재구축되는 것이다
Peter Naur, Programming as Theory Building (1985)
여기서 그가 말하는 '이론'은 수학적 명제나 형식 명세에 한정되지 않는다고 이해해야한다. 나우르가 말하고자 하는 '이론'은 프로그램이 현실의 문제를 어떻게 다루고 왜 이런 형태를 취하는지 설명하면서, 새로운 변경 요구에도 대응할 수 있는 '사람의 이해'를 뜻한다. 같은 소스 코드를 가지고 있어도 어떤 조건때문에 이 예외를 만들어두었는지, 비슷해 보이는 결과물을 왜 추상화 하지 않았는지와 같은 이해를 가진 것은 아니다.8
결국 이론을 가진 팀이 해체되면, 프로그램은 죽는다. 실행은 계속되고 코드도 남지만, 그것을 안전하게 고칠 수 있는 사람은 사라지기 때문이다. (해커뉴스에서 구조조정 뉴스가 나올 때마다 나우르가 소환되는 이유다.) 그래서 그는 문서만으로 프로그램의 원래 이론을 완전히 재구축하는 것은 불가능하다고 보았다. 따라서 새로운 개발자에게 이론을 계승시키려면 기존 개발자와의 긴밀한 협업이 필요하며, 이론이 이미 소실된 프로그램을 새로운 팀이 부활(Revival)시키는 작업은 예외적인 상황에서만 시도해야 한다고 주장했다.
다시 테세우스의 배로 돌아가 보자. 만약 배의 판자를 갈아 끼우던 목수들이 모두 떠나고, 설계도(문서)만 남았다면 어떻게 될까?
배는 여전히 바다 위에 떠 있고, 물건도 실어 나를 수 있다. 그러나 새로운 항로를 개척해야 하거나 선체를 개조해야한다면 과연 이 배를 계속 쓸 수 있을까?
어느 목수가 왜 특정 항로를 위해 돛대를 작게 만들었는지, 선미를 왜 그 모양으로 설계했는지 설명할 사람이 없어지면, 다른 곳으로 사람을 실어 나른다는 배의 원래 목적을 달성할 수가 없는 것이다.
새로운 목수는 설계도를 보고 판자를 교체할 수는 있겠지만, 그 변경이 기존 배의 설계 의도와 양립하는지는 알 수 없다.배는 죽지 않았다. 하지만 배를 이해하던 지식의 연속성은 끊어졌다.
나우르가 말한 프로그램의 죽음도 이와 유사하다.
그럼에도 불구하고 언제나 소프트웨어는 문제를 가지고 있다.
나우르가 말한 이론을 가진 목수들이 모두 남아 있다고 가정해 보자. 선체를 왜 그렇게 만들었는지도 알고, 설계도도 갖고 있고, 어느 판자를 갈아 끼워야 하는지도 이해하고 있다.
그렇다면 이 배를 고치는 일은 쉬워질까?
물론 이전보다 나을 것이다. 적어도 왜 그렇게 만들었는지 몰라서 배를 망가뜨리는 일은 줄어들 터이니 말이다. 하지만 새로운 항로를 개척해야 한다면 어떻게 될까? 지구 온난화로 바다가 거칠어지고, 선주의 욕심으로 화물을 더 많이 태워야 한다고 하며, 돈때문에 선주는 더 빠르게 목적지에 도착하라고 요구한다.
목수들이 기존의 배를 완벽하게 이해한다고 해서 이 요구와 환경 변화를 어떻게 조화시킬 것인지에 대한 답까지 저절로 얻어지는 것은 아니다.
결국 우리는 서로 다른 두 문제를 마주한다.
하나는 프로그램을 이해할 수 있는가의 문제이고, 다른 하나는 이해하고도 해결해야 하는 문제 자체가 얼마나 어려운가의 문제다.
1986년, 프레더릭 브룩스는 이 둘을 구별할 수 있는 또 다른 기준을 제시했다.
(Frederick Phillips Brooks Jr.)
7. 1986년 - 브룩스: 문제 자체의 어려움을 구별하기
나우르가 '프로그램의 죽음'을 이야기하며 사람과 이해의 중요성을 강조했다면, 이쯤에서 우리는 이런 질문을 던지게 된다.
"도대체 이 복잡하고 고통 스러운 소프트웨어를 한번에 해결해 줄 무언가를 만들 수 없을까?"
1986년, 프레더릭 브룩스(Frederick P. Brooks Jr.)는 「No Silver Bullet: Essence and Accidents of Software Engineering」이라는 논문에서 이 질문에 아주 냉혹한 대답을 내놓는다. 미래의 기술이나 관리 기법 하나로 생산성을 월등히 높여줄 '은탄환'은 존재하지 않는다는 것이다.9
There is no single development, in either technology or management technique, which by itself promises even one order-of-magnitude improvement within a decade in productivity, in reliability, in simplicity.
향후 10년 안에 생산성, 신뢰성, 단순성 측면에서 단일 기술이나 관리 기법 하나만으로 10배의 개선을 약속할 만한 개발은 존재하지 않는다.
Frederick P. Brooks Jr., No Silver Bullet (1986)
왜일까? 브룩스는 소프트웨어의 어려움을 '우연적 어려움(Accidental)'과 '본질적 어려움(Essential)'으로 나눈다.
우연적 어려움은 문법이 불편하거나 도구가 낙후되어 생기는 문제다. 이는 좋은 언어와 도구가 나오면 해결된다. 하지만 본질적 어려움은 소프트웨어가 가진 고유한 속성이라 도구로 해결할 수 없다는 것이다.
그가 꼽은 본질적 어려움은 네 가지다.
복잡성(Complexity), 다른 사람이 만든 제도와 인터페이스에 맞춰야 하는 순응성(Conformity), 계속 바뀌어야 하는 변경 가능성(Changeability), 그리고 공간에 그려 볼 수 없는 비가시성(Invisibility)이다.
앞서 레먼이 관찰한 '끊임없는 변경 요구'도 브룩스의 관점에서는 소프트웨어가 피할 수 없는 숙명일 뿐이다.
그래서 브룩스는 사람들이 흔히 '이것만 있으면 소프트웨어 개발이 편해질 것'이라고 생각한 수단들을 하나씩 검토하며, 비판적인 의견을 달기 시작한다. 프로그래머는 남의 의견을 곧이곧대로 듣지 않는 성격이라는게 여실히 들어나는데, 그중에서 필자가 가장 재밌게 본 부분은 이 부분이다.
바로 Artificial intellgence 즉, AI다. 1986년의 AI는 지금과 달랐지만, 어쨌건 인공지능이 발전하면 소프트웨어 생산성과 품질을 획기적으로 개선할 것이라는 기대가 있었던 모양이다. 그리고 브룩스는 그 기대에 단 3단어로 답했다.
I do not.
나는 그렇게 생각하지 않는다.
Frederick P. Brooks Jr., No Silver Bullet (1986)
이 사람은 도대체 뭘 믿는 걸까?
사실 이때의 AI의 정의가 지금과 달랐다는 것을 떠나서, 그는 소프트웨어 개발에서 진짜 어려운 일이 무엇인지를 다음과 같이 설명한다.
The hard thing about building software is deciding what to say, not saying it.
소프트웨어를 만드는 데 어려운 것은 무엇을 말할지 결정하는 것이지, 그것을 표현하는 일이 아니다.
AI 시대에 들어서 더욱 와닿는 말이다.
다시 테세우스의 배로 돌아가 보자.
이제 목수들에게는 배의 판자를 만들어 주는 기계가 생겼다. 설계도를 읽고, 낡은 부품을 찾아내고, 새로운 선체의 설계까지 제안해 주는 기계다.
그렇다면 목수는 필요 없어지는 것일까?
없어지는 것을 만드는 사람들
Science is what we understand well enough to explain to a computer. Art is everything else we do.
과학은 우리가 컴퓨터에 설명할 수 있을 만큼 충분히 이해한 것이고, 예술은 그 밖에 우리가 하는 모든 일이다.
— Donald E. Knuth, Foreword to A=B (1995년 집필, 1996년 출간).
여기까지 소프트웨어 공학의 사상사를 아주 일부 살펴봤다.
물론 불만이 있을 것이다. 도널드 크누스는 어디 갔는가? 바버라 리스코프는? 앨런 케이는? 마틴 파울러,켄트 벡은? 그 밖에도 이 글에 나오지 않은 위대한 컴퓨터 과학자들은 셀 수 없이 많다.
변명하자면, 이 사람들을 전부 데려와 테세우스의 배를 설명하려다가는 조선소를 차리게 생겼을 것이다.
생각해 보니 앞에서 소개했던 브룩스가 이미 답을 알려주었다. 지연된 프로젝트에 사람을 더 투입하면 프로젝트는 더 늦어진다는 것이다. 원고도 마찬가지였다. 학자를 한 명 더 추가할 때마다 글이 끝날 시점은 점점 멀어졌다. 브룩스의 법칙을 이렇게 몸소 실천할 줄은 몰랐다.
여기서 진짜 중요한 것은 학자들의 이름을 외우는 게 아니라, 그들이 세상에서 가 불만이 많은 사람들이었고, 그들만의 세계관과 멘탈 모델을 가지고 있다는 것이다.
크누스의 말처럼 우리가 어떤 문제를 완전히 이해해서 컴퓨터에 설명할 수 있게 되는 순간, 그 일은 자동화되어 사라질 것이다.
어제까지 사람이 손으로 하던 일이 오늘의 프로그램이 되어 없어지는 것이다.
그렇다면 그 일들 전체를 컴퓨터에 다 설명하고 나면, 즉 코드로 만들어져 없어지고 난 뒤에 남는 '그 밖의 모든 일'은 무엇일까? 그것이 바로 프로그래머가 세상을 바라보고 문제를 쪼개는 머릿속의 지도, 멘탈 모델이다.
지금까지 살펴본 선배들의 이야기도 결국 각자의 멘탈 모델에 관한 투쟁이었다. 다이크스트라는 두개골의 크기에 맞춘 명료함을, 파르나스는 변경을 가두는 경계를, 레먼은 환경과 프로그램이 서로를 바꾸는 공진화를 보았다. 배커스는 상태 변화 대신 함수의 대수적 조합을, 보엠은 비용과 리스크의 저울질을, 나우르와 브룩스는 코드 너머에 있는 사람의 이해(Theory)와 문제의 본질을 보았다.
처음 던졌던 테세우스의 배 질문에 이제 답을 내릴 수 있다. 처음에 짠 코드가 한 줄도 남지 않고 전부 새로 갈아 끼워졌는데도 우리가 그것을 여전히 같은 프로그램이라고 부를 수 있는 이유가 무엇일까?
우리가 만든 진짜 결과물은 텍스트 파일에 적힌 코드가 아니라 프로그래머의 멘탈 모델이기 때문이다. 이 배가 어떤 바다를 건너야 하는지, 왜 저 API는 일부러 느리게 만들어 두었는지, 어디까지가 판자이고 어디부터가 건드리면 안 되는 용골인지를 규정하는 그 머릿속의 세계관이 바로 소프트웨어의 자산일 것이다.
결국 프로그래머란 끊임없이 자기 일을 없애는 기계를 만들면서, 끝내 기계에게 넘겨줄 수 없는 자기만의 멘탈 모델을 벼려내는 사람들이다. 그리고 굳이 남과 부딪혀서 자신의 멘탈 모델이 세상에서 가장 옳다고 증명해 보려는 싸움꾼이다.
그리고 가끔 나는 선배들이 재밌는 것들을 너무 많이 해결했다고 생각한다. 하지만 늘 그렇듯 새로운 문제가 나올 것이다. 수 많은 문제가 생겼다가 사라졌다.
소프트웨어의 역사는 '없어지는 것'을 만드는 역사였다. 기계어를 고수준 언어로 감쌌고, 반복되는 비즈니스 로직을 프레임워크라는 틀 안에 가두었고, 어려운 복잡성을 계속 다른 부분으로 이전하며, 우리는 끊임없이 인간의 인지적 부담을 덜어내 왔다.
AI 시대에서는 이제 '생성 방식'이 근본적으로 바뀌었다.
이제 사람들은 가끔 코드를 쓰지만, AI와 대화해서 문제를 해결하는 사람도 점차 늘어난다. 과거에는 멘탈 모델을 코드로 매핑해야하지만, 이제는 그 매핑의 과정을 기계가 도맡는다.
우리는 코드를 짜는 사람에서 '무엇을 만들지 기계에게 설명하는 사람'으로 변모되고 있다. 이것은 맞는 길일까? 아니면 다시 코드를 쓰는 방향으로 되돌아갈까? 정확한 답은 알 수 없을 것이다.
오늘도 인터넷에서는 AI는 쓰레기만 만든다라는 사람들과 AI로 더 복잡한 것을 만들 수 있다라고 하는 사람들끼리 피를 토하며 싸운다.
누가 이길지는 모르겠다. 다만 분명한 것은, 이 싸움 끝에 또 누군가가 나타나 수십 년 전의 할아버지 할머니들이 그랬듯 새로운 시대의 멘탈 모델을 정립할 것이라는 것이다.
나는 늘 새로운 인물을 갈망한다. 내 홈페이지는 양로원이다. 대부분의 글들은 지금은 할아버지, 할머니가 된 인물들로 도배 되어있다. 이제는 좀 젊은 사람의 사진을 걸어두고, 숭배하고 싶다. 나는 시류에 편승하는 것을 매우 좋아하는 사람이기 때문에, "내가 이 사람을 일찌감치 알아봤다"라며 숭배할 준비가 되어 있다. 언제까지 양로원 원장으로만 남아 있을 수는 없지 않은가?
각주
- 소프트웨어 테크놀로지 그룹에서 가져온 사진 ↩
- Edsger W. Dijkstra, The Humble Programmer, EWD340, 『Communications of the ACM』 15(10), 1972, 859~866쪽. 텍사스대학교의 저자 아카이브 전사본. 정확성 증명과 프로그램의 동시 구성은 강연의 세 번째 논거에서 다룬다. 게재본 스캔. ↩
- David L. Parnas, On the Criteria To Be Used in Decomposing Systems into Modules, 『Communications of the ACM』 15(12), 1972, 1053~1058쪽. 대학 보존 전사본. DOI. ↩
- L. A. Belady, M. M. Lehman, A Model of Large Program Development, 『IBM Systems Journal』 15(3), 1976, 225~252쪽. 이 항목은 출판사 서지와 초록을 확인했으며, 진화 관점의 구체적인 설명은 다음 1980년 논문 원문과 대조했다. DOI. ↩
- Meir M. Lehman, Programs, Life Cycles, and Laws of Software Evolution, 『Proceedings of the IEEE』 68(9), 1980, 1060~1076쪽. E형 프로그램의 피드백은 1062~1063쪽에서 설명한다. 이 논문의 분류는 S형(명세가 옳음의 기준), P형(현실 문제의 근사해를 내며 결과가 쓸 만한지로 평가), E형(현실에 내장돼 그 현실을 바꿈)이다. 진화 법칙은 다섯 개로 정리돼 있다. 지속적 변화(쓰이는 프로그램은 바뀌지 않으면 점점 덜 쓸모 있어짐), 복잡도 증가(줄이려는 작업이 없으면 구조가 복잡해짐), 대형 프로그램 진화의 자기 조절, 조직 안정성 보존(작업률이 대체로 일정), 친숙성 보존(릴리스마다 바뀌는 양이 대체로 일정). 법칙은 이후 논문에서 여덟 개로 늘고 표현도 달라졌다. DOI. ↩
- John Backus, Can Programming Be Liberated from the von Neumann Style? A Functional Style and Its Algebra of Programs, 『Communications of the ACM』 21(8), 1978, 613~641쪽. 1977년 튜링상 강연과 구체적인 FP 체계를 구분해 읽었다. DOI. ↩
- Barry W. Boehm, Software Engineering Economics, Prentice-Hall, 1981. ISBN 9780138221225. 출간 정보는 출판사 서지로, COCOMO의 연도와 추정 범위는 연구센터의 COCOMO 81 안내로 확인했다. Basic COCOMO의 노력 추정식(인월)은 조직형(organic) 2.4·KDSI^1.05, 반분리형(semidetached) 3.0·KDSI^1.12, 내장형(embedded) 3.6·KDSI^1.20이다. Intermediate 모형은 기본 노력 식의 계수부터 달라서 같은 유형 순서로 3.2·KDSI^1.05, 3.0·KDSI^1.12, 2.8·KDSI^1.20을 사용하고, 이 값에 제품·하드웨어·인력·프로젝트 특성에서 정한 15개 비용 요인의 승수를 곱한다. Detailed 모형은 개발 단계별로 달라지는 승수와 작업 분해까지 반영한다. 따라서 Basic의 계산값에 비용 승수만 붙이는 것으로 세 모형의 차이를 설명할 수는 없다. 여기서 KDSI는 납품 소스 명령문 수를 천 개 단위로 센 값이며, 임의로 센 파일의 물리적 줄 수나 CPU 명령어 수와 동일시하지 않는다. Intermediate의 계수와 계산 절차는 다음 1984년 논문의 표 V와 본문에서도 확인할 수 있다. 단계별 추정 오차 범위 그림은 1981년 책에 있다. ↩
- Peter Naur, Programming as Theory Building, 『Microprocessing and Microprogramming』 15(5), 1985, 253~261쪽. 링크한 재수록본 가운데 나우르의 논문 본문을 사용했으며 앞뒤 편집자 해설은 저자의 발언으로 취급하지 않았다. 프로그램의 죽음·되살리기와 문서만을 통한 이론 복구의 한계는 재수록본 400~401쪽을 참조했다. DOI90032-8). ↩
- Frederick P. Brooks Jr., No Silver Bullet: Essence and Accidents of Software Engineering, University of North Carolina, TR86-020, 1986년 9월. 처음 발표된 곳은 『Information Processing 86: Proceedings of the IFIP 10th World Computer Congress』(H.-J. Kugler 편, Elsevier/North-Holland, 1986, 더블린 1986년 9월 1~5일)다. 회의록 서지. 『Computer』 20(4), 1987년 4월 게재판과 구별한다. 1987년 게재판 DOI. ↩