
토큰과 토크나이저
개요
토큰(token)은 언어 모델이 텍스트 입력과 출력을 처리할 때 사용하는 이산적인 기본 단위이고, 토크나이저(tokenizer)는 원시 문자열을 그 단위의 시퀀스와 정수 식별자(token ID)로 양방향 변환하는 도구다. 어휘 설계에 따라 단어 하나가 토큰 하나가 될 수도 있지만, 부분 단어(subword) 조각이나 단일 문자, 혹은 UTF-8 바이트 조각이 토큰이 될 수도 있다. 따라서 고양이 → 귀엽다 같은 표기는 사람 눈높이의 어절·단어 수준 설명일 뿐이며, 실제 모델이 보는 토큰 경계를 말하려면 어떤 토크나이저와 어휘 표(vocabulary)를 썼는지부터 지정해야 한다.
토큰 식별자는 어휘 표 가 각 토큰에 부여한 정수 인덱스 이다. 번호의 크고 작음 자체에 어휘의 의미가 들어 있는 것은 아니며, 모델은 임베딩 행렬 의 번째 행 벡터 를 조회해 문맥 계산의 출발점으로 삼는다. 동일한 문자열이라도 정규화(normalization)·사전 분할(pre-tokenization)·모델 분할 규칙과 어휘 표가 달라지면 전혀 다른 토큰 시퀀스와 식별자 열로 바뀐다1.
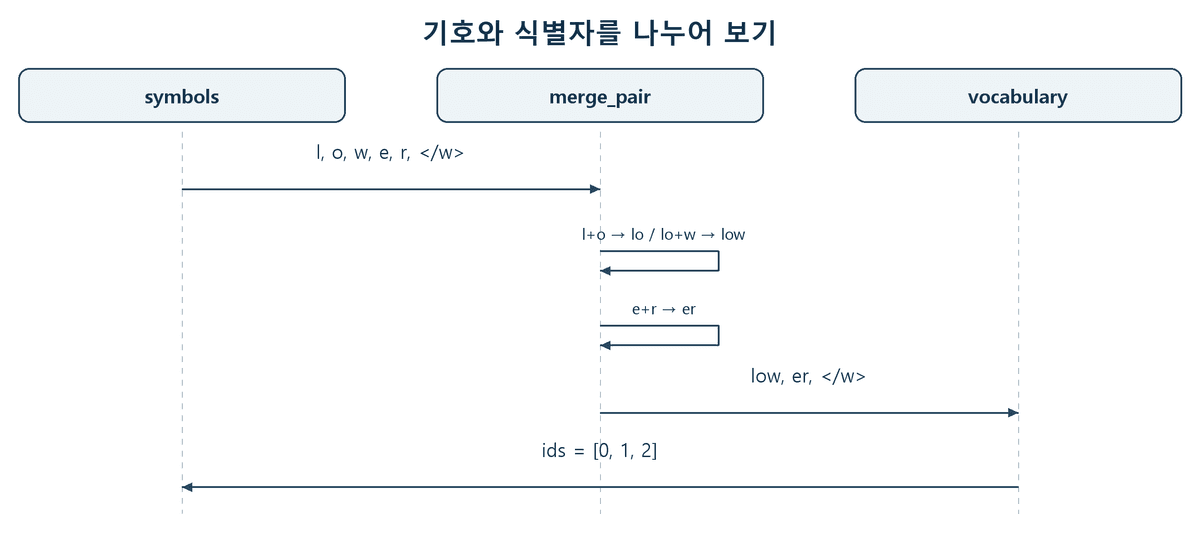
위 그림은 아래 코드 예제를 설명하기 위해 정의한 소규모 병합 규칙과 어휘 표다. 특정 상용 LLM 서비스의 실제 분할 결과를 그대로 옮긴 그림이 아니므로 규칙과 어휘 표의 의존성을 읽는 용도로만 사용한다.
작은 조각을 합쳐 토큰으로 만들기
Philip Gage(1994)가 데이터 압축 알고리즘으로 제안한 바이트 쌍 인코딩(BPE, byte pair encoding)2을 부분 단어 분할에 도입한 방식에서는, 학습 말뭉치에서 가장 자주 인접해 등장하는 기호 쌍 를 찾아 하나의 새 기호 로 병합하는 규칙을 순서대로 만든다. 반면 Kudo와 Richardson(2018)의 SentencePiece 등에서 지원하는 유니그램(unigram) 부분 단어 모델은 후보 분할 집합 가운데 조각들의 로그 확률 합을 최대화하는 분할 를 찾는다.
아래 Python과 C++20 코드는 말뭉치에서 빈도를 세는 학습 단계 대신 세 가지 병합 규칙 ("l", "o"), ("lo", "w"), ("e", "r")가 이미 정해졌다고 가정하고, 입력 단어 "lower"에 규칙을 순서대로 적용해 부분 단어 토큰과 정수 식별자를 얻는 과정을 보여준다.
def merge_pair(symbols, pair):
    merged = []
    i = 0
    while i < len(symbols):
        if i + 1 < len(symbols) and tuple(symbols[i:i + 2]) == pair:
            merged.append(symbols[i] + symbols[i + 1])
            i += 2
        else:
            merged.append(symbols[i])
            i += 1
    return merged

if __name__ == "__main__":
    symbols = list("lower") + ["</w>"]
    rules = [("l", "o"), ("lo", "w"), ("e", "r")]
    for pair in rules:
        symbols = merge_pair(symbols, pair)
    vocabulary = {"low": 0, "er": 1, "</w>": 2}
    ids = [vocabulary[symbol] for symbol in symbols]
    assert symbols == ["low", "er", "</w>"]
    assert ids == [0, 1, 2]
    print(symbols, ids)
실행 결과:
['low', 'er', '</w>'] [0, 1, 2]동일한 병합 규칙 적용과 어휘 표 정수 ID 매핑을 C++20으로 구현하면 다음과 같다.
#include <iostream>
#include <string>
#include <unordered_map>
#include <utility>
#include <vector>

std::vector<std::string> mergePair(
    const std::vector<std::string>& symbols,
    const std::pair<std::string, std::string>& rule) {
  std::vector<std::string> merged;
  for (std::size_t i = 0; i < symbols.size();) {
    if (i + 1 < symbols.size() && symbols[i] == rule.first &&
        symbols[i + 1] == rule.second) {
      merged.push_back(symbols[i] + symbols[i + 1]);
      i += 2;
    } else {
      merged.push_back(symbols[i]);
      ++i;
    }
  }
  return merged;
}

int main() {
  std::vector<std::string> symbols{"l", "o", "w", "e", "r", "</w>"};
  const std::vector<std::pair<std::string, std::string>> rules{
      {"l", "o"}, {"lo", "w"}, {"e", "r"}};
  for (const auto& rule : rules) {
    symbols = mergePair(symbols, rule);
  }
  const std::unordered_map<std::string, int> vocab{
      {"low", 0}, {"er", 1}, {"</w>", 2}};
  for (const auto& sym : symbols) std::cout << sym << ' ';
  std::cout << "->";
  for (const auto& sym : symbols) std::cout << ' ' << vocab.at(sym);
  std::cout << '\n';
  return 0;
}
실행 결과:
low er </w> -> 0 1 2merge_pair(mergePair)의 입력은 이미 나뉜 기호 시퀀스와 길이 2의 병합 쌍이다. 예제에서 </w>는 단어 경계(끝)를 표시하기 위해 붙인 기호이고, 식별자 0, 1, 2도 이 예제의 작은 어휘 표에서 임의로 배정한 값이다. 만약 이 어휘 표에 없는 기호를 번호로 바꾸려 하면 Python에서는 KeyError, C++에서는 std::out_of_range 예외가 발생하므로, 임의의 미등록 문자열까지 닫힌 어휘(open vocabulary)로 처리하려면 모든 기본 문자나 UTF-8 바이트(256종)를 기초 어휘에 포함하거나 미등록 토큰(<unk>) 처리 규칙을 갖추어야 한다.
또한 이름에 "byte"가 들어간다는 이유만으로 모든 BPE 토크나이저가 UTF-8 원시 바이트에서 출발한다고 가정해서는 안 된다. Sennrich 등(2016)의 초기 신경망 기계번역 BPE는 유니코드 문자(character) 시퀀스에서 출발하며, GPT-2 계열의 바이트 수준 BPE(byte-level BPE)는 UTF-8 바이트를 기초 단위로 삼는다.
원논문에 나온 병합 규칙
Sennrich·Haddow·Birch의 Neural Machine Translation of Rare Words with Subword Units(ACL 2016)는 희귀 단어와 미등록 단어(out-of-vocabulary)를 부분 단어 시퀀스로 분해해 번역하는 BPE 방법을 정립했다3. 아래 그림은 원논문 §3.2가 제시하는 작은 사전의 BPE 병합 예시다.
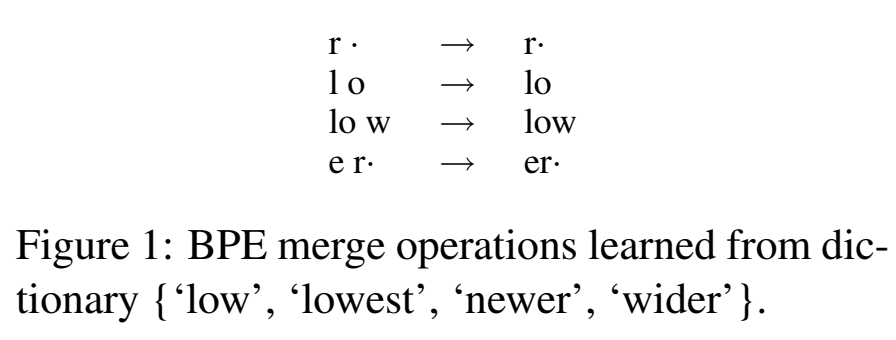
위 그림은 Sennrich 등(2016) 그림 1(PDF 4쪽·논문 1718쪽)을 발췌한 것이다(해당 쪽, © 2016 Association for Computational Linguistics, ACL 이용 조건). 왼쪽 기호 쌍을 오른쪽의 새 기호로 차례로 합치며, 단어 끝 표지(·)도 조각에 포함된다. 앞서 살펴본 코드 예제는 설명을 단순화하기 위해 별도로 정한 세 규칙만 사용한 것이다.
문자 수·바이트 수와 토큰 수를 나누어 보기
한국어 문자열 고양이는 유니코드 코드 포인트(code point)로는 3글자이고, UTF-8 인코딩으로는 한 글자당 3바이트씩 총 9바이트다. 하지만 이 사실만으로는 특정 언어 모델에서 몇 개의 토큰으로 분할되는지 알 수 없다. 토크나이저의 어휘 표가 고양이 전체를 단일 토큰으로 가지고 있을 수도 있고, 음절이나 자모·바이트 조각으로 쪼갤 수도 있기 때문이다. 더욱이 복합 이모지나 결합 자모에서는 유니코드 코드 포인트 개수조차 사람이 눈으로 세는 글자(서기소 클러스터, grapheme cluster) 개수와 일치하지 않는다.
Kudo와 Richardson의 SentencePiece(EMNLP 2018)는 언어별 사전 띄어쓰기 도구에 의존하지 않고 원시 문자열에서 직접 부분 단어 모델(BPE 및 unigram)을 학습·적용하며, 공백을 메타 기호 ▁(U+2581)로 치환해 가역적 디코딩을 지원한다4. 다만 NFKC 같은 유니코드 정규화 규칙이 함께 켜진 설정에서는 인코딩 후 디코딩한 문자열이 원본과 바이트 단위로 완전히 같다고 가정할 수 없다.
따라서 모델의 문맥 창(context window) 한도와 API 과금 토큰 수를 계산할 때에는 대상 모델과 정확히 같은 토크나이저 버전과 설정을 사용해야 하며, 본문 텍스트뿐 아니라 시스템·역할 구분용 특수 토큰(예: <|im_start|>, <|eot_id|>)과 메시지 템플릿이 추가하는 토큰 수까지 함께 세어야 한다.
같이 보기
각주
- Hugging Face Tokenizers Documentation, “The Tokenization Pipeline.” 문서. ↩
- Philip Gage, “A New Algorithm for Data Compression,” The C Users Journal 12(2), 1994, pp.23–38. 아카이브 원문, ACM 서지. ↩
- Rico Sennrich, Barry Haddow, Alexandra Birch, “Neural Machine Translation of Rare Words with Subword Units,” Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics (ACL), 2016, §3.2, Figure 1, pp.1715–1725. ACL Anthology, DOI. ↩
- Taku Kudo, John Richardson, “SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing,” Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing (EMNLP): System Demonstrations, 2018, §2–3, pp.66–71. ACL Anthology, DOI. ↩