
전이 학습과 음의 전이
개요
전이 학습(transfer learning)은 원천 영역(source domain) 와 원천 과제 에서 얻은 지식을 목표 영역(target domain) 의 목표 과제 를 학습하는 데 활용하는 방법이다1. 이미 학습한 표현과 매개변수를 초기값으로 가져올 수도 있고, 원천 표본의 가중치를 조절하거나 두 영역의 특징 공간을 정렬할 수도 있다. 따라서 전이 학습을 논할 때에는 무엇을 옮겨 어떤 목표 지표를 개선하려는지부터 먼저 고정해야 한다.
양의 전이(positive transfer)와 음의 전이(negative transfer)는 원천 지식을 결합했을 때 목표 과제의 성능이 기준선보다 어느 방향으로 달라졌는지를 가리킨다2. 출력 문장에 긍정적인 어휘가 들어갔는지나 응답의 주관적 인상이 좋은지를 뜻하는 말이 아니다. 동물 소개 글에서 익힌 문체 표현이 과학 관찰 보고서의 사실 정확성을 높이는지 해치는지처럼, 목표 과제와 평가 기준을 함께 놓아야 부호가 정해진다.
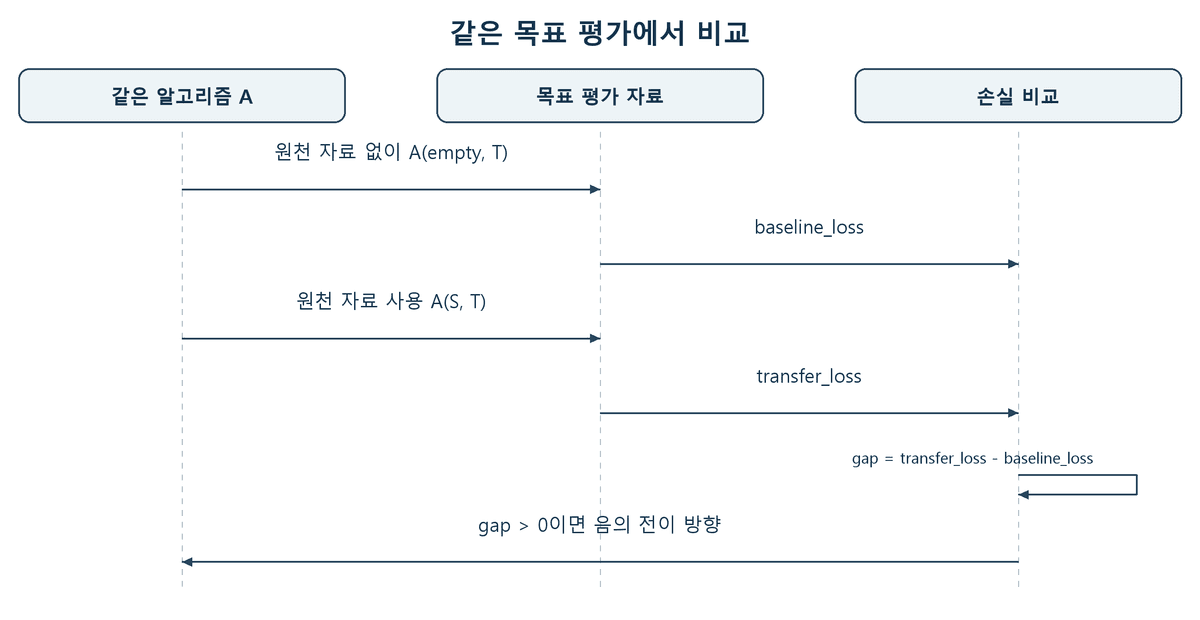
위 관계도의 두 경로는 동일한 목표 자료 와 동일한 평가 조건에서 비교한다. 모델 구조나 최적화 절차, 목표 학습 자료의 크기까지 함께 바뀌었다면 원천 자료의 영향과 설계 변경의 영향을 분리해서 해석해야 한다.
같은 기준선에서 나빠졌는지 보기
Wang 등의 Characterizing and Avoiding Negative Transfer(CVPR 2019)는 학습 알고리즘 를 고정한 뒤 원천 자료 를 함께 쓰는 가설 와 목표 자료 만 쓰는 기준선 의 목표 기대 손실(위험, risk) 를 비교해 음의 전이를 정의한다3. 서로 다른 알고리즘의 최선 성능끼리 비교하면 원천 자료가 미친 영향과 알고리즘 자체의 귀납 편향 차이가 섞이기 때문이다.
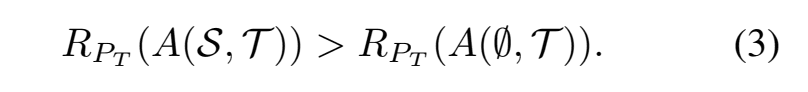
위 그림은 Wang 등(2019) §3의 식 (3)(저자 공개 arXiv 사본 2쪽)을 발췌한 것이다(해당 쪽). 왼쪽 는 원천 자료와 목표 자료를 함께 쓴 모델의 목표 위험이고, 오른쪽 는 같은 알고리즘을 목표 자료에만 적용한 기준선의 목표 위험이다. 값이 작을수록 좋은 손실(loss)을 기준으로 왼쪽이 더 크면, 즉 위험 격차 이면 음의 전이 조건을 만족한다.
기대 위험 는 목표 분포 전체에 대한 기댓값이므로 실제 실험에서는 유한한 검증·시험 표본의 평균 손실로 추정한다. 아래 표와 Python·C++20 코드는 위험 격차의 부호를 설명하기 위한 가상 수치이며, 특정 논문이나 대규모 언어 모델의 실측 실험값을 옮긴 것이 아니다.
목표 과제 손실 | 원천 자료 없음 | 원천 자료 사용 | 사용한 쪽의 변화 () |
|---|---|---|---|
가상 사례 A | 0.10 | 0.06 | (손실 감소, 양의 전이 방향) |
가상 사례 B | 0.10 | 0.18 | (손실 증가, 음의 전이 방향) |
가상 사례 C | 0.10 | 0.10 | (차이 없음) |
- 목표 과제 손실
가상 사례 A
- 원천 자료 없음 $R_T(A(\emptyset, T))$
0.10
- 원천 자료 사용 $R_T(A(S, T))$
0.06
- 사용한 쪽의 변화 ($\Delta R_T$)
(손실 감소, 양의 전이 방향)
- 목표 과제 손실
가상 사례 B
- 원천 자료 없음 $R_T(A(\emptyset, T))$
0.10
- 원천 자료 사용 $R_T(A(S, T))$
0.18
- 사용한 쪽의 변화 ($\Delta R_T$)
(손실 증가, 음의 전이 방향)
- 목표 과제 손실
가상 사례 C
- 원천 자료 없음 $R_T(A(\emptyset, T))$
0.10
- 원천 자료 사용 $R_T(A(S, T))$
0.10
- 사용한 쪽의 변화 ($\Delta R_T$)
(차이 없음)
baseline_loss = 0.10
transfer_losses = [0.06, 0.18, 0.10]
# 같은 알고리즘과 목표 평가에서 R_T(A(S, T)) - R_T(A(∅, T))를 계산한다.
gaps = [round(loss - baseline_loss, 2) for loss in transfer_losses]
assert gaps[0] < 0
assert gaps[1] > 0
assert gaps[2] == 0
print(gaps)
실행 결과:
[-0.04, 0.08, 0.0]같은 위험 격차 를 C++20으로 계산하면 다음과 같다.
#include <array>
#include <iomanip>
#include <iostream>

int main() {
  constexpr double baselineLoss = 0.10;
  constexpr std::array<double, 3> transferLosses{0.06, 0.18, 0.10};

  std::cout << std::fixed << std::setprecision(2);
  for (std::size_t i = 0; i < transferLosses.size(); ++i) {
    // 양수이면 원천 자료를 추가했을 때 목표 위험(손실)이 커진 음의 전이 방향이다.
    double gap = transferLosses[i] - baselineLoss;
    std::cout << gap << (i + 1 == transferLosses.size() ? '\n' : ' ');
  }
  return 0;
}
실행 결과:
-0.04 0.08 0.00여기서 격차가 양수()라는 것은 원천 자료를 추가했을 때 목표 손실이 늘었다는 뜻이므로 음의 전이 방향이다. 반대로 정확도(accuracy)나 점수처럼 값이 클수록 좋은 지표를 쓴다면 부호 해석이 반대가 된다. 실제 실험 결론을 내릴 때에는 난수 시드에 따른 학습 분산과 평가 표본의 통계적 불확실성도 함께 점검해야 하며, 단일 출력 사례 하나가 어색하다는 관찰만으로 음의 전이를 단정할 수는 없다.
옮기는 대상은 한 가지가 아니다
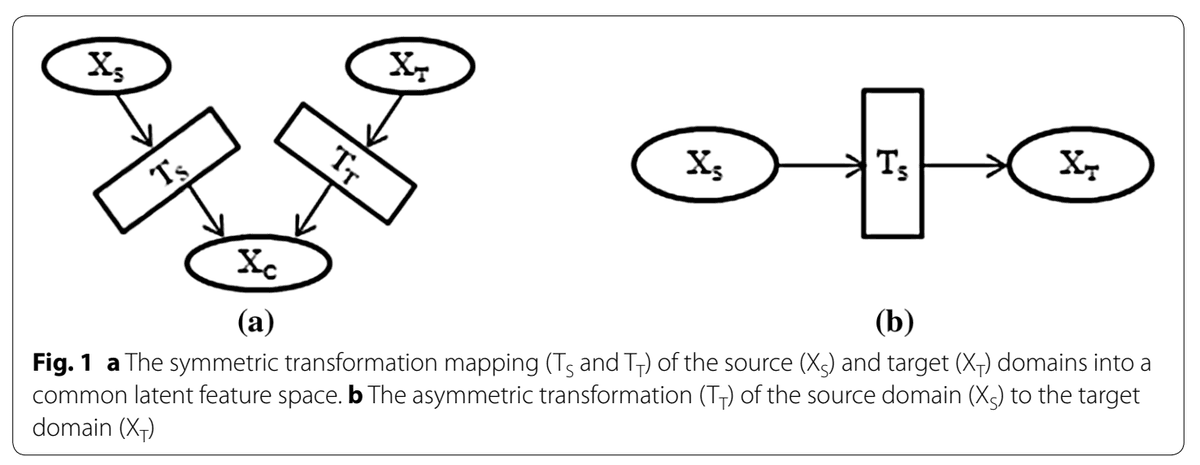
Weiss·Khoshgoftaar·Wang(2016), A survey of transfer learning의 그림 1은 특징 기반 전이(feature-based transfer)의 두 가지 설계를 대조한다4(원문 그림, CC BY 4.0). (a) 대칭 변환은 원천 영역과 목표 영역을 모두 공통 잠재 특징 공간으로 사상하고, (b) 비대칭 변환은 한 영역의 특징을 다른 영역의 표현 공간 쪽으로 변환한다. 이는 도메인 적응에서 특징 분포 차이를 줄이는 설계 예시이며, 사전학습된 신경망 체크포인트를 미세조정하는 계산 그래프 자체를 그린 그림은 아니다.
사전학습·미세조정·문맥 내 학습에서 다루는 매개변수 전이(parameter transfer)와 위 그림의 특징 공간 변환, 그리고 원천 표본에 중요도 가중치를 부여하는 인스턴스 전이(instance transfer)는 구현 메커니즘이 서로 다르다. "전이"라는 단어만으로는 가중치를 갱신했는지, 잠재 표현 사상을 학습했는지, 프롬프트의 문맥 예시만 바꿨는지가 자동으로 결정되지 않는다.
가까운 전이·먼 전이와 기존 역량 간섭
심리학과 교육학에서 유래한 가까운 전이(near transfer)·먼 전이(far transfer)는 학습한 과제의 구조·표현과 새로운 평가 조건 사이의 거리(유사도)를 가리키는 축이고, 양의 전이·음의 전이는 목표 과제 성능의 증감 방향을 가리키는 축이다. 두 영역이 표면적으로 비슷해 보여도 레이블 조건부 분포 가 어긋나면 음의 전이가 발생할 수 있다.
또한 사전학습된 모델을 특정 목표 과제(예: 수식 축약이나 간결한 코드 생성)에 맞춰 추가 학습할 때, 새로운 과제에서는 양의 전이가 일어나더라도 이전에 보유하던 일반 서술·독해 과제의 성능이 저하되는 현상이 나타날 수 있다. 신경망 학습에서는 이를 파국적 망각(catastrophic forgetting) 또는 간섭(catastrophic interference)이라 부르며5, 특정 보상이나 형식 제약에 맞춘 사후 조정이 다른 목표 과제에서 음의 전이를 유발했는지 검증하려면 원래 과제와 목표 과제의 평가 지표를 동일한 기준선 위에서 함께 측정해야 한다.
같이 보기
각주
- Sinno Jialin Pan and Qiang Yang, "A Survey on Transfer Learning," IEEE Transactions on Knowledge and Data Engineering 22(10), 2010, pp. 1345-1359. https://home.cse.ust.hk/~qyang/Docs/2009/tkdetransferlearning.pdf ↩
- Michael T. Rosenstein, Zvika Marx, Leslie Pack Kaelbling, and Thomas G. Dietterich, "To Transfer or Not to Transfer," NIPS 2005 Workshop on Inductive Transfer: 10 Years Later, 2005. ↩
- Zirui Wang, Zihang Dai, Barnabás Póczos, and Jaime Carbonell, "Characterizing and Avoiding Negative Transfer," Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2019, §3, Eq. (3). https://arxiv.org/pdf/1811.09751 ↩
- Karl Weiss, Taghi M. Khoshgoftaar, and DingDing Wang, "A survey of transfer learning," Journal of Big Data 3(9), 2016, Figure 1 (CC BY 4.0). https://link.springer.com/article/10.1186/s40537-016-0043-6 ↩
- James Kirkpatrick et al., "Overcoming catastrophic forgetting in neural networks," Proceedings of the National Academy of Sciences (PNAS) 114(13), 2017, pp. 3521-3526. https://www.pnas.org/doi/10.1073/pnas.1611835114 ↩