
사전학습·미세조정·문맥 내 학습
개요
사전학습(pretraining), 미세조정(fine-tuning), 문맥 내 학습(in-context learning, ICL)은 언어 모델이 이전에 구축한 표현이나 현재 주어진 정보를 활용하는 서로 다른 단계와 방식을 가리킨다. 세 개념을 구별할 때 가장 먼저 확인해야 할 기준은 손실 기울기로 모델 매개변수(가중치) 를 갱신하는 학습 절차가 실행되는지, 아니면 가중치 를 고정한 채() 입력 문맥만 달리 주어 추론하는지다.
이 글은 앞선 문맥 토큰들로부터 다음 토큰을 예측하는 자기회귀 언어 모델(autoregressive language model)을 기준으로 설명한다. 사전학습과 미세조정의 구체적인 목적 함수는 양방향 마스킹이나 선호도 최적화 등 모델과 과제에 따라 달라질 수 있으며, 토큰과 토크나이저에서 다룬 정수 토큰 시퀀스 가 여기서 모델의 입력과 예측 대상이 된다.
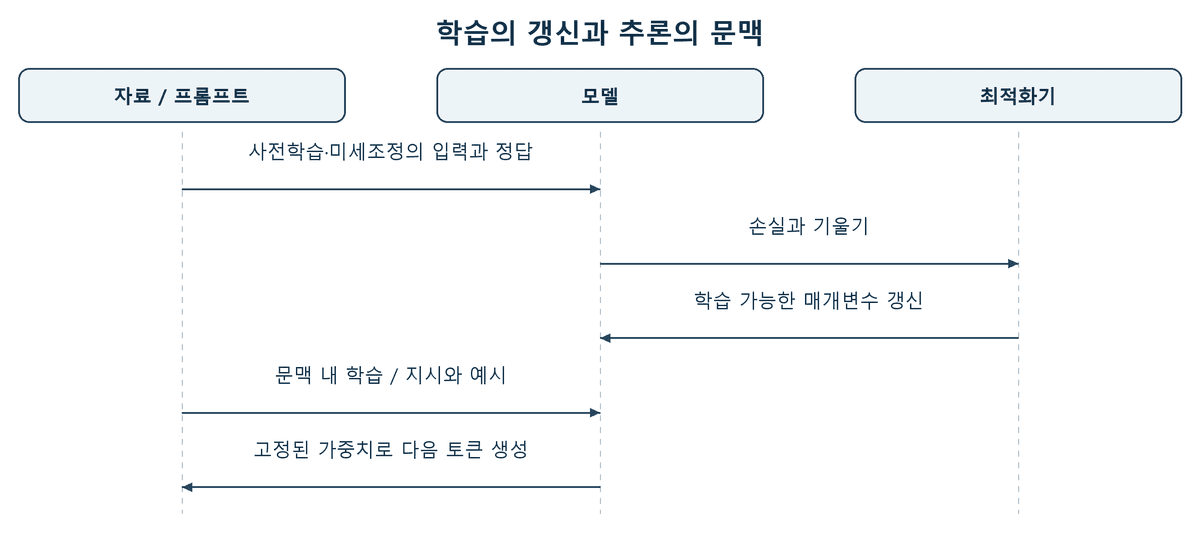
위 도해에서 사전학습과 미세조정은 손실 계산과 최적화기(optimizer)를 거쳐 체크포인트 가중치를 바꾸지만, 문맥 내 학습은 고정된 가중치 위에서 현재 프롬프트 시퀀스를 조건으로 삼아 출력을 생성한다.
다음 토큰을 맞히며 가중치를 바꾸기
자기회귀 사전학습에서는 이전 시점까지의 토큰열 이 주어졌을 때 실제 다음 토큰 의 조건부 확률 를 최대화하도록 음의 로그 우도(교차 엔트로피) 손실을 최소화한다1. 매 학습 단계마다 손실 에 대한 기울기 를 구해 학습률 와 최적화 규칙에 따라 가중치를 갱신한다.
학습 토큰 시퀀스
  -> 현재 가중치로 다음 토큰 확률 계산
  -> 실제 다음 토큰과 비교해 손실 계산
  -> 기울기 계산과 최적화
  -> 갱신한 가중치로 다음 학습 단계 진행
정답 토큰의 로그 확률을 높이는 학습 목적 함수와, 추론 시점에 다음 토큰을 선택하는 디코딩 규칙(탐욕적 선택, 빔 탐색, 온도·상위 확률 샘플링 등)은 서로 구별해야 한다2. 또한 어느 디코딩 방식을 쓰더라도 모델이 부여한 토큰 확률이 곧 생성된 문장의 사실성이나 진실성을 보증하는 값은 아니다.
이미 학습한 모델을 과제에 맞추기
미세조정(fine-tuning)은 사전학습된 체크포인트 가중치 를 초기값으로 삼아, 목표 작업의 자료와 손실 함수로 추가 기울기 갱신을 수행하는 과정이다. 모델 전체의 매개변수를 갱신하는 전체 미세조정(full fine-tuning)도 있고, 기존 가중치 행렬 는 동결한 채 저계수(low-rank) 어댑터 행렬 등 일부 학습 가능한 매개변수만 갱신하는 매개변수 효율적 미세조정(PEFT, 예: LoRA)도 있다3. 어느 쪽이든 "사전학습된 모델로 응답을 생성했다"와 "역전파와 최적화기로 학습 가능한 매개변수를 갱신했다" 사이의 경계가 핵심이다.
Radford 등의 Improving Language Understanding by Generative Pre-Training(2018)은 대규모 비표지 텍스트 말뭉치에서 자기회귀 사전학습을 수행한 뒤, 정답 레이블이 있는 목표 과제(분류·함의·유사도·객관식 질의응답)에 맞춰 입력 토큰 배열을 구성하고 모델을 미세조정하는 구조를 제시했다.
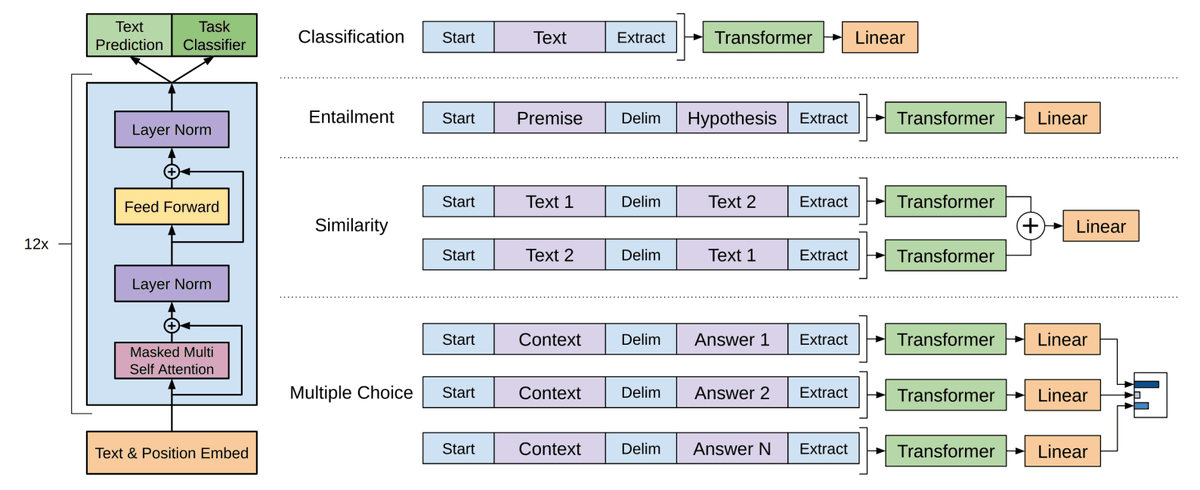
위 그림은 Radford 등(2018) 그림 1(PDF 4쪽)을 발췌한 것이다(그림이 있는 쪽). 오른쪽의 과제별 입력 시퀀스 변환은 정답 레이블을 이용해 선형 출력층과 트랜스포머 가중치를 함께 미세조정할 때 쓰이는 구도로, 추론 프롬프트에 예시 몇 개를 적어 넣기만 한 문맥 내 학습과 구별해 읽어야 한다.
예시를 현재 문맥에 넣기
문맥 내 학습(in-context learning)은 과제 지시문이나 개의 입출력 예시 쌍 와 질의 를 하나의 입력 문맥으로 묶어 모델에 전달하고, 가중치 갱신 없이() 조건부 분포에서 응답을 생성하는 방식이다. Brown 등의 Language Models are Few-Shot Learners(NeurIPS 2020)는 과제별 기울기 갱신 없이 프롬프트 안의 예시 개수(zero-shot, one-shot, few-shot)만 달리하며 대규모 언어 모델의 성능을 비교했다4.
다음 낱말을 영어로 옮겨라.
고양이 -> cat
강아지 -> dog
토끼 ->
이 프롬프트의 앞선 두 줄은 번역 과제와 화살표 출력 형식을 문맥 안에서 지정한다. 모델이 이 예시를 읽고 적절한 단어를 이어 썼더라도, 그 추론 호출로 인해 모델 체크포인트의 가중치 가 영구적으로 바뀐 것은 아니다. 문맥 예시를 활용해 답하는 능력 자체는 앞선 사전학습·미세조정 단계에서 형성되었더라도, 추론 시점의 순전파(forward pass) 계산과 이전의 가중치 학습 과정은 명확히 구분해야 한다.
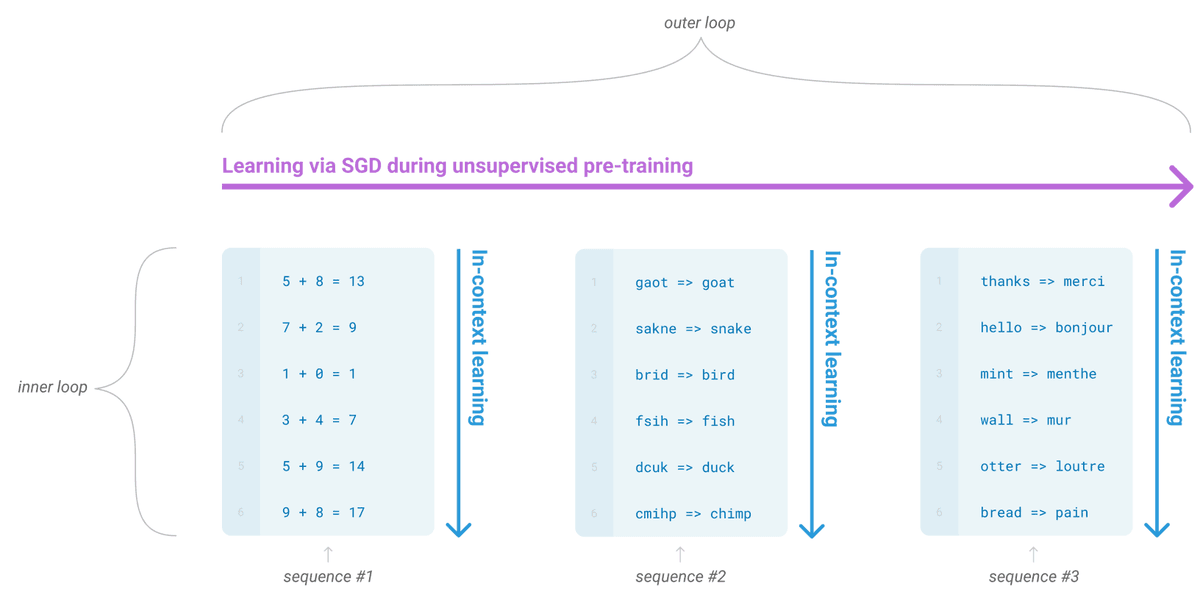
위 그림은 Brown 등(2020) 그림 1.1(PDF 3쪽)을 발췌한 것이다(해당 쪽). 보라색 가로 화살표(outer loop)는 수많은 문서 시퀀스를 거치며 가중치를 갱신하는 사전학습 흐름이고, 파란색 세로 화살표(inner loop)는 단일 시퀀스 내부에서 앞선 예시들을 조건으로 삼아 추론하는 문맥 내 학습 흐름이다.
기울기 하강으로 매개변수 를 직접 갱신하는 미세조정과, 추론 중 매개변수 변화량이 인 문맥 내 학습의 차이를 Python과 C++20 코드로 대조하면 다음과 같다.
w_pretrained = 1.20
lr = 0.10
grad_loss = -0.80  # 목표 과제 자료에서 계산한 손실 기울기

# 1. 미세조정: 기울기 하강으로 매개변수 w를 갱신한다.
w_fine_tuned = w_pretrained - lr * grad_loss

# 2. 문맥 내 학습: 추론 중 매개변수 w를 고정한 채 문맥 조건만 바꾼다.
w_icl = w_pretrained

print(f"fine_tuned_w={w_fine_tuned:.3f} delta_w={w_fine_tuned - w_pretrained:.3f}")
print(f"icl_frozen_w={w_icl:.3f} delta_w={w_icl - w_pretrained:.3f}")
실행 결과:
fine_tuned_w=1.280 delta_w=0.080
icl_frozen_w=1.200 delta_w=0.000
동일한 매개변수 갱신 유무를 C++20으로 나타내면 다음과 같다.
#include <iomanip>
#include <iostream>

int main() {
  const double wPretrained = 1.20;
  const double lr = 0.10;
  const double gradLoss = -0.80;

  // 1. 미세조정: 학습 단계에서 기울기 갱신으로 매개변수가 바뀐다.
  const double wFineTuned = wPretrained - lr * gradLoss;

  // 2. 문맥 내 학습: 추론 중 매개변수는 그대로 고정된다(delta_w = 0).
  const double wIcl = wPretrained;

  std::cout << std::fixed << std::setprecision(3);
  std::cout << "fine_tuned_w=" << wFineTuned
            << " delta_w=" << (wFineTuned - wPretrained) << '\n';
  std::cout << "icl_frozen_w=" << wIcl
            << " delta_w=" << (wIcl - wPretrained) << '\n';
  return 0;
}
실행 결과:
fine_tuned_w=1.280 delta_w=0.080
icl_frozen_w=1.200 delta_w=0.000
무엇이 다음 호출에도 남는가
과정 | 현재 단계에서 바뀌는 것 | 결과를 다음 호출에 다시 쓰려면 |
|---|---|---|
사전학습 (Pretraining) | 모델의 학습 가능한 매개변수 | 학습이 끝난 체크포인트 가중치를 불러온다 |
미세조정 (Fine-tuning) | 전체 또는 일부(예: LoRA 어댑터) 학습 가능한 매개변수 | 미세조정된 체크포인트나 어댑터 가중치를 불러온다 |
문맥 내 학습 (In-context learning) | 현재 입력 토큰 시퀀스와 순전파 내부 활성화 상태(KV 캐시 등) | 다음 요청에도 필요한 지시문·예시 문맥을 프롬프트에 포함해 전달한다 |
- 과정
사전학습 (Pretraining)
- 현재 단계에서 바뀌는 것
모델의 학습 가능한 매개변수
- 결과를 다음 호출에 다시 쓰려면
학습이 끝난 체크포인트 가중치를 불러온다
- 과정
미세조정 (Fine-tuning)
- 현재 단계에서 바뀌는 것
전체 또는 일부(예: LoRA 어댑터) 학습 가능한 매개변수
- 결과를 다음 호출에 다시 쓰려면
미세조정된 체크포인트나 어댑터 가중치를 불러온다
- 과정
문맥 내 학습 (In-context learning)
- 현재 단계에서 바뀌는 것
현재 입력 토큰 시퀀스와 순전파 내부 활성화 상태(KV 캐시 등)
- 결과를 다음 호출에 다시 쓰려면
다음 요청에도 필요한 지시문·예시 문맥을 프롬프트에 포함해 전달한다
실제 대화형 서비스가 이전 대화 기록을 데이터베이스에 저장하거나 외부 문서를 검색해(RAG) 프롬프트에 자동으로 다시 끼워 넣는 기능은 애플리케이션 계층의 상태·검색 경로에 해당한다(참조: 상태). 이전 대화 내용이 다음 응답에 반영되었다는 관찰만으로는 모델 가중치가 실시간으로 미세조정되었는지 알 수 없으므로, 체크포인트 매개변수가 갱신되었는지 아니면 요청 문맥에 이전 기록이 다시 주입되었는지를 구별해 확인해야 한다.
같이 보기
각주
- Alec Radford, Karthik Narasimhan, Tim Salimans, Ilya Sutskever, “Improving Language Understanding by Generative Pre-Training,” OpenAI Technical Report, 2018, §3.1–3.2. 원문. ↩
- Hugging Face Transformers Documentation, “Causal language modeling.” 문서. ↩
- Edward J. Hu et al., “LoRA: Low-Rank Adaptation of Large Language Models,” International Conference on Learning Representations (ICLR), 2022. arXiv 원문. ↩
- Tom B. Brown et al., “Language Models are Few-Shot Learners,” Advances in Neural Information Processing Systems (NeurIPS) 33, 2020, §1–2, Figure 1.1. arXiv 원문. ↩