
백프레셔
파일을 읽는 쪽은 초당 100개를 내보내고, 읽어온 자료를 처리하는 쪽은 초당 60개를 끝낸다고 해보자. 차이가 계속되는 동안에는 초마다 40개가 쌓인다. 버퍼를 키우면 잠깐 버틸 수 있지만, 처리 속도의 차이가 유지되면 새 버퍼도 결국 찬다.
백프레셔(backpressure)는 이런 상황에서 받는 쪽의 여유가 보내는 쪽으로 전달돼, 상류의 생산이나 전송을 조절하는 방식이다. 데이터는 생산자에서 소비자로 흐르고, 더 받을 수 있는지에 관한 신호는 반대 방향으로 돌아간다. 유한한 자원을 가진 처리 단계들이 서로 속도를 맞추는 문제라고 볼 수 있다.
수신자의 여유를 발신자에게 알려주기
이 문제는 비동기 스트림 라이브러리보다 오래됐다. 1981년 TCP 명세인 RFC 793은 수신 측이 지금 받을 수 있는 바이트 수를 윈도(window)로 알려주고 송신 측이 그 범위에 맞춰 보내는 흐름 제어를 설명한다. 발신자에게 전송할 데이터가 더 있어도 수신자의 여유를 함께 고려하는 방식이다. 여기서 백프레셔라는 용어가 처음 생겼다고 단정할 수는 없지만, 받는 쪽의 제약을 보내는 쪽에 전달하는 오래된 프로토콜 사례는 확인할 수 있다. RFC 793 §2.6.
TCP가 신호를 주고받는 단위는 바이트이고, 애플리케이션의 큐는 항목 수를, 스트림 API는 요청한 원소 수를 다루기도 한다. 같은 문제를 서로 다른 계층에서 푸는 셈이다. 다만 TCP 수신 버퍼에 여유가 있다는 사실만으로 주문 처리나 파일 변환까지 끝났다고 볼 수는 없으니, 애플리케이션 내부에 무제한 큐를 두면 TCP 위에서도 작업은 계속 쌓일 수 있다.
흐름 제어와 혼잡 제어가 나뉘는 이유도 통제하려는 대상이 다르기 때문이다. 흐름 제어는 수신자의 수용 능력을 보고, 혼잡 제어는 네트워크 경로의 혼잡을 다룬다. 현재 TCP 기본 명세인 RFC 9293도 송신 윈도와 혼잡 윈도를 구별한다. RFC 9293 §3.8.2·§3.8.6.
비동기 처리에서 생기는 적체
같은 스레드에서 함수를 차례로 부르면 호출이 끝날 때까지 다음 일을 시작하지 않는 구조가 자연스럽게 속도를 묶는다. 처리를 큐나 별도 작업으로 넘기면 생산자는 소비자의 완료를 기다리지 않고 앞으로 갈 수 있는데, 그 사이의 적체를 어디에 얼마나 둘지가 새로 문제가 된다.
이 때문에 '비동기'와 '자원을 제한한다'는 것은 별개의 설계다. 소비자가 늦어졌을 때 생산자가 계속 넣을 수 있는 큐는 두 실행을 분리해주지만, 속도를 맞추는 역할까지 맡지는 않는다. 버퍼의 상한과 상류에 신호를 돌려주는 경로가 있어야 기다림이 생산 속도에 영향을 준다.
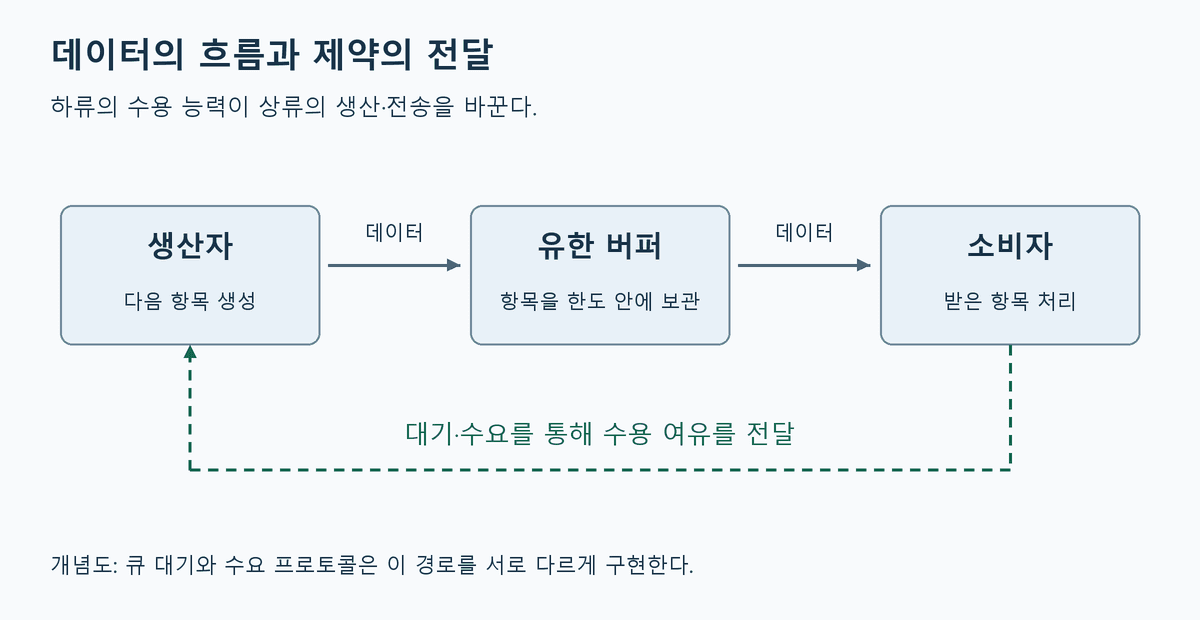
그림의 위쪽 화살표는 데이터가 이동하는 방향이고, 아래쪽은 대기나 수요 신호가 상류에 전달되는 방향이다. 직접 그린 개념도로, 특정 라이브러리의 클래스 구조나 통신 패킷 형식을 나타내지는 않는다.
예를 들어 생산자가 큐의 put 완료를 기다리면, 큐가 찼다는 제약이 생산자에게 전달된다. 반면 큐에 넣는 작업을 계속 별도 Task로 만들면 큐 자체의 항목 수는 작게 유지해도, 큐 바깥에서 대기하는 작업이 늘 수 있다. 시스템 전체에서 어느 단계가 생산을 멈추는지 따라가야 하는 이유다.
라이브러리 사이의 약속이 된 수요 신호
Reactive Streams는 비동기 스트림을 구현하는 라이브러리들이 이런 신호를 공통으로 주고받도록 인터페이스와 규칙을 정했다. 1.0.0 태그가 가리키는 커밋은 2015년 4월의 기록이며, 공식 발표는 비차단 백프레셔가 있는 비동기 스트림 처리를 표준화한다는 목표를 밝힌다. 큐를 하나 잘 만드는 문제에서, 서로 다른 구성 요소를 연결해도 흐름 제어의 약속이 유지되는 문제로 범위가 넓어진 것이다. 1.0.0 기록, 공식 발표.
(원문 출처)
공식 소개의 첫 문장을 2026년 10월 28일 캡처했다. 소개문이 밝히는 목표를 보여주는 발췌이며, 개별 프로토콜 규칙은 아래의 명세에서 확인한다. 명세와 MIT-0 이용 조건.
여기서는 Publisher가 데이터를 내보내고 Subscriber가 받으며, Subscription이 그 사이의 요청과 취소를 연결한다. Subscriber는 request(n)으로 추가로 받을 수 있는 원소 수를 알린다. 명세의 Publisher 규칙 1.1은 누적 전달량이 누적 요청량을 넘지 못하게 하고, Subscription 규칙 3.8은 새 요청량이 남은 수요에 더해진다고 정한다. Reactive Streams 1.0.4 규칙 1.1·3.8.
request(2) 뒤에 원소 하나를 받았다면 남은 수요는 하나다. 이어서 request(3)을 호출하면 남은 수요가 넷이 된다. 이 수치는 예제용이며, 초당 네 개를 뜻하는 속도 제한은 아니다. 또 요청은 전달 가능한 양을 허용하는 신호이므로, 생산자는 데이터가 없거나 스트림이 끝나면 요청한 양보다 적게 전달할 수 있다.
Java 9의 java.util.concurrent.Flow도 Publisher·Subscriber·Subscription·Processor라는 인터페이스를 제공한다. 공식 문서는 이를 Reactive Streams 명세에 대응하는 흐름 제어로 설명한다. 이런 표준화가 필요한 까닭은 데이터를 보내는 메서드만 맞춰서는 수요·취소·종료를 함께 연결할 수 없기 때문이다. Java 9 Flow, Subscription의 수요·취소 계약.
기다림을 구현하는 방법이 달라졌다
방식 | 소비자의 제약이 전달되는 경로 | 주의할 범위 |
|---|---|---|
동기 호출·블로킹 쓰기 | 호출이 돌아오기 전까지 다음 전송을 기다린다 | 대기하는 동안 스레드를 점유할 수 있다 |
제한된 비동기 큐 | 큐가 차면 생산자 코루틴의 | 생산자가 그 완료를 기다려야 한다 |
pull 방식 | 소비자가 다음 값을 요청할 때 생산을 진행한다 | 내부 선읽기·별도 큐가 있으면 그 범위도 살핀다 |
수요 기반 스트림 | 남아 있는 요청량 안에서 원소를 전달한다 | 원소 수와 처리 완료·바이트 수는 구별한다 |
- 방식
동기 호출·블로킹 쓰기
- 소비자의 제약이 전달되는 경로
호출이 돌아오기 전까지 다음 전송을 기다린다
- 주의할 범위
대기하는 동안 스레드를 점유할 수 있다
- 방식
제한된 비동기 큐
- 소비자의 제약이 전달되는 경로
큐가 차면 생산자 코루틴의
put을 보류한다- 주의할 범위
생산자가 그 완료를 기다려야 한다
- 방식
pull 방식
- 소비자의 제약이 전달되는 경로
소비자가 다음 값을 요청할 때 생산을 진행한다
- 주의할 범위
내부 선읽기·별도 큐가 있으면 그 범위도 살핀다
- 방식
수요 기반 스트림
- 소비자의 제약이 전달되는 경로
남아 있는 요청량 안에서 원소를 전달한다
- 주의할 범위
원소 수와 처리 완료·바이트 수는 구별한다
공통으로 필요한 것은 하류의 제약이 상류의 행동을 바꾸는 연결이다. 블로킹 구현은 스레드를 기다리게 할 수 있고, 비동기 구현은 작업의 재개를 미뤄 다른 일을 실행하게 할 수 있다. Reactive Streams가 비차단을 요구하는 까닭은 여러 비동기 단계를 연결하면서 제어 신호 자체가 스레드를 붙잡는 일을 피하려는 데 있다. Reactive Streams의 문제와 범위.
그래서 비차단을 '기다림이 사라졌다'고 읽으면 곤란하다. 기다림이 수요나 재개 조건으로 표현될 수 있는 것이고, 이미 시작한 업무를 언제 완료로 볼지는 별도의 계약이다. 원소를 받았다는 신호와 DB에 저장을 끝냈다는 신호를 같은 뜻으로 쓰면 처리 중인 작업 수를 제대로 세기 어렵다.
큐 두 칸으로 보는 작은 예
다음은 Python 3.11 이상의 단독 실행 예제다. maxsize=2인 큐에 생산자가 값을 하나씩 넣고 그 완료를 기다린다. 큐가 차면 await queue.put()이 해당 코루틴을 보류하며, 이벤트 루프는 소비자 같은 다른 작업을 실행할 수 있다. asyncio.Queue.
import asyncio

async def produce(queue):
    for item in range(6):
        await queue.put(item)
    await queue.put(None)

async def consume(queue):
    values = []
    while True:
        item = await queue.get()
        if item is None:
            return values
        await asyncio.sleep(0.01)
        values.append(item)

async def main():
    queue = asyncio.Queue(maxsize=2)
    async with asyncio.TaskGroup() as group:
        group.create_task(produce(queue))
        consumer = group.create_task(consume(queue))
    assert consumer.result() == list(range(6))
    print(consumer.result())  # [0, 1, 2, 3, 4, 5]

if __name__ == "__main__":
    asyncio.run(main())
여기서 None은 입력 값으로 쓰지 않는 종료 표지다. 단일 소비자가 앞선 값을 순서대로 처리한 뒤 표지를 받고 끝나며, 부모는 TaskGroup을 나갈 때 두 작업의 종료를 기다린다. 완료 항목 수를 따로 세는 join과 task_done은 이 흐름에 필요하지 않아 넣지 않았다.
소비자가 일반 예외로 실패하면 TaskGroup이 생산자도 취소한다. 개별 소비자에 대한 취소는 이 실패 규칙과 다르게 취급되므로, 두 작업을 중단할 때는 부모 작업의 취소처럼 전체 수명도 함께 끝나는 경로가 필요하다. 이 예제의 큐 대기를 Reactive Streams 프로토콜 전체를 구현한 것으로 해석해서는 안 된다. TaskGroup의 실패·취소 규칙.
버퍼·속도 제한과 구별하는 까닭
장치 | 직접 정하는 것 | 백프레셔와의 관계 |
|---|---|---|
버퍼 상한 | 기다리는 데이터를 얼마나 둘지 | 가득 찼을 때의 처리가 상류로 전달돼야 흐름이 바뀐다 |
레이트 리미터 | 일정 시간에 허용할 양 | 고정된 허용량은 소비자의 실제 여유와 다를 수 있다 |
동시 실행 상한 | 동시에 처리할 작업 수 | 남는 요청을 무제한 대기열에 두면 적체는 남는다 |
드롭·접수 거절 | 무엇을 받지 않거나 버릴지 | 생산자를 늦출 수 없는 경계에서 별도 정책이 필요하다 |
- 장치
버퍼 상한
- 직접 정하는 것
기다리는 데이터를 얼마나 둘지
- 백프레셔와의 관계
가득 찼을 때의 처리가 상류로 전달돼야 흐름이 바뀐다
- 장치
레이트 리미터
- 직접 정하는 것
일정 시간에 허용할 양
- 백프레셔와의 관계
고정된 허용량은 소비자의 실제 여유와 다를 수 있다
- 장치
동시 실행 상한
- 직접 정하는 것
동시에 처리할 작업 수
- 백프레셔와의 관계
남는 요청을 무제한 대기열에 두면 적체는 남는다
- 장치
드롭·접수 거절
- 직접 정하는 것
무엇을 받지 않거나 버릴지
- 백프레셔와의 관계
생산자를 늦출 수 없는 경계에서 별도 정책이 필요하다
큐의 두 칸은 대기 중인 항목 수를 제한한다. 소비자가 이미 꺼내 처리하는 항목, 다음 값을 들고 기다리는 생산자, 다른 단계의 큐는 그 두 칸 바깥에 있으므로 전체 메모리의 바이트 상한과는 구별해야 한다. 위 예제는 생산자 하나와 소비자 하나만 두어 그 경로를 따라갈 수 있게 했다.
센서 측정이나 마우스 이동처럼 원래의 발생원을 원하는 대로 늦출 수 없는 입력도 있다. 이때 스트림 경계에서 버퍼링하거나 값을 합치거나 버리는 정책을 정할 수 있지만, 발생한 데이터를 모두 보존한다는 보장은 별도로 검토해야 한다. Reactive Streams 명세 역시 발생 속도를 바꿀 수 없는 소스에서도 수요의 상한을 지키기 위해 버퍼링이나 드롭이 필요할 수 있다고 설명한다. 명세의 Subscriber-controlled queue bounds.
이처럼 백프레셔는 TCP, 큐, 스트림에서 하나의 구현으로 존재하는 기능이 아니라, 단계 사이에서 수용 능력을 전달하는 방식으로 나타난다. 연혁을 따라보면 바이트 단위의 흐름 제어, 비동기 단계 사이의 적체, 라이브러리가 공유하는 수요 프로토콜이 왜 같은 문제와 연결되는지도 드러난다. 구현을 볼 때는 데이터가 흐르는 방향과 함께 제약이 되돌아가는 경로를 읽으면 된다.